一個代碼倉庫任務的快速判斷
此 SWE-2 審查並不是聲稱我通過生產代碼倉庫獨立運行了該模型。我沒有具有與工程團隊使用的相同代碼倉庫、權限和部署條件的 Devin 工作區。相反,在將編碼模型視為為真正的代碼倉庫工作做好準備之前,我會列出我希望看到的單任務審查。
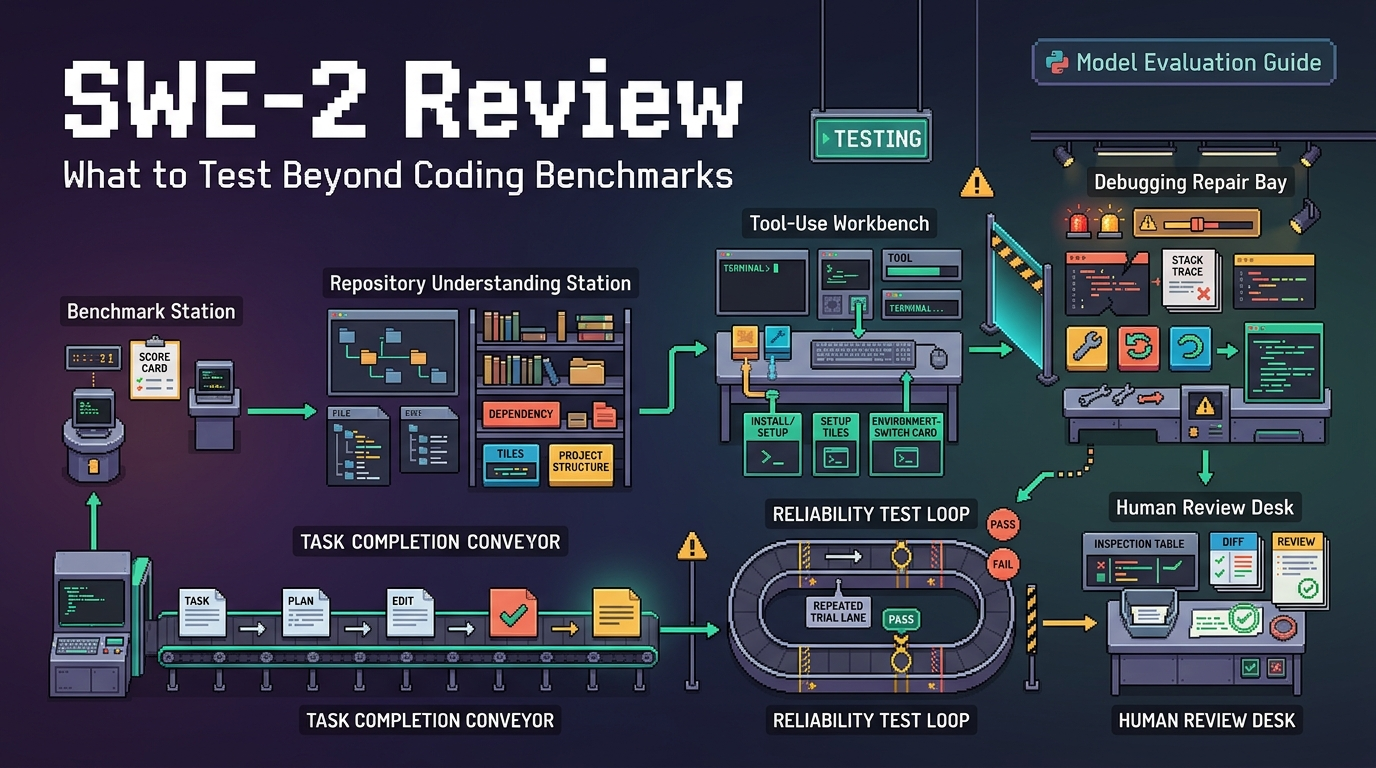
我是莉娜。我的快速結論很簡單:SWE-2 看起來值得在 Devin 中進行評估,但編碼基準只是決定的開始。有用的問題不在於模型是否可以產生合理的補丁。關鍵在於它是否可以進入一個不熟悉的代碼庫,找到重要的限制,更改最小的正確內容,證明更改,在第一個路徑中斷時恢復,並留下一些可供人類查看的內容,而無需重建整個會話。
這種區別很重要,因為 Cognition 報告的供應商運行結果在 FrontierCode 1.1 Main 上為 50.0%,在 DeepSWE 1.1 上為 73.0%,在 Terminal-Bench 2.1 上為 92.8%。它們是有關 2026 年 9 月 10 日版本的信號,而不是獨立複製團隊軟件的成功率。同一個 SWE-2 發佈公告 表示桌面和 CLI 可用,同時推出了 Web 和 Fusion。我會測試團隊計劃使用的確切表面。
我如何在 Devin 中測試 SWE-2
對於真正的代碼倉庫智能體測試,我將使用一項現有的、重要的更改,而不是綜合提示或廣泛的功能請求。它應該足夠小,可以一次複習,但又足夠真實,需要找到依賴關係並尊重既定的模式。一個好的候選者是具有可重現的失敗測試、範圍狹窄的驗證更改或記錄的行為差距的錯誤,其中可以在不解釋的情況下檢查驗收標準。
在開始之前,我會記錄 Devin 表面、選定的模型、顯示的工作設置、日期、提交 SHA、分支規則、鎖定文件、工具、網絡狀態以及初始通過或失敗的命令。我還會設定時間和嘗試預算,並在開始任務後保存每個人工提示。這可以防止一個乾淨的演示悄然成為一個不同的實驗。
代碼倉庫、任務、環境和驗收標準
簡報應命名行為、受影響的區域和終點線:重現指定的錯誤,進行最小的兼容更改,添加或調整迴歸測試,運行規定的檢查,並返回可審查的差異。除非普通受讓人知道,否則它不應該命名文件。我會提前聲明所需的註冊表、憑據等機密信息或瀏覽器登錄,而不是因為模型失敗而錯誤地缺少訪問權限。
基線必須是誠實的。如果代碼倉庫在任務之前沒有構建,我將保存日誌並將該失敗與智能體創建的失敗區分開來。如果規定的接受命令保持紅色,則綠色子集不計算在內。當地的説明和測試可能會指導模型,但它們屬於記錄。
SWE-2 在編輯之前可以理解代碼庫嗎?
我會檢查路徑,而不僅僅是最終代碼。強大的會話可在編輯之前識別執行路徑、相關測試、配置邊界和附近約定。這並不會獎勵無休止的搜索。 Cognition 表示,在 FrontierCode 運行中,SWE-2 媒體編輯早於 SWE-1.7;僅當跳過的讀取無關緊要時,速度才重要。
查找約束、依賴關係和現有模式
我想問它認為必須保留什麼:公共 API 行為、錯誤處理、授權、數據形狀、向後兼容性或類似的約定。然後我會將該答案與代碼倉庫進行比較。它是否找到了真正的調用者,使用了已建立的測試助手,並注意到功能標誌、生成的產物、遷移或包邊界?
真正的代碼倉庫智能體測試的這一部分應該產生證據,而不是聽起來有信心的分數。有用的產物是它檢查的文件、它命名的約束以及範圍與它們匹配的差異。一次令人驚訝的短暫探索可能會很棒;很長的補丁仍然可能會錯過使補丁不安全的依賴性。即使測試通過,我也會將請求區域之外的無法解釋的編輯視為審查結果。
SWE-2 能否提供經過驗證的變更?
實施是 SWE-2 編碼模型必須負責的地方。我會尋找一個最小的補丁,一個沒有它就會失敗的迴歸測試,以及來自實際代碼倉庫環境的輸出。對於界面或工作流程,我會添加一項輕量級手動檢查,而不是假設單元覆蓋範圍講述了整個故事。
實施、測試和最終移交
交接應該説明哪些內容發生了變化、原因、哪些內容發生了變化以及哪些內容仍然不確定。乾淨的拉取請求描述並不能證明。我會從新的結帳或 CI 作業重新運行接受命令,檢查不相關的流失,並確認分支保護仍然適用。
我希望所有貢獻者都遵循相同的標準:沒有發明通過測試,沒有聲稱已執行的不可用服務,並且沒有隱藏在自信摘要中的跳過命令。 NIST 生成式 AI 配置文件 類似地圍繞背景和風險構建評估,而不是通用能力標籤。這不是 Devin 或 SWE-2 的採購決定。
人類干預仍然重要的地方
人為干預是一種測量。這個真實的代碼倉庫智能體測試將編碼智能體為干預視為命名事件:一個人澄清了需求,授予了預期許可,修復了環境,解釋了約定,在有效的產品行為之間進行了選擇,或者糾正了診斷。將它們合併為一個計數會使智能體看起來比以前更糟糕或更自主。
澄清、失敗的測試和恢復
最能説明問題的時刻可能是編輯後第一次失敗的測試。我會保留診斷、證據、恢復情況以及人類是否提供了新事實。當編碼智能體縮小假設範圍、檢查故障、修改補丁並重新運行檢查時,它的故障恢復能力很強;當它反覆更改代碼或擴大差異時,它就很弱。
我不會僅僅為了讓會議變得戲劇化而製造失敗。但是,當真正的依賴項、測試或環境問題阻止任務時,它就屬於結果。對於編碼智能體來説,恢復質量是交付質量的一部分。它告訴我一個人是在審查工作還是默默地成為智能體的調試者。
已發佈的基準未證明什麼
已發佈的基準可以表明模型在指定的工具下完成了定義的任務。他們沒有確定它理解您的架構,擁有您的權限,啓動您的工具鏈,尊重您的發佈流程,或者將從您的票證中的特定模糊性中恢復。它們也不能使 SWE-2 和 SWE-bench 互換:SWE-2 是 Cognition 的型號名稱,而 SWE-bench 是基準系列。
供應商的數據特別容易被過度解讀,因為它們很精確。他們應該始終攜帶其來源、基準版本和日期。單個分數不能成為對實際代碼倉庫成功的預測,也不能告訴工程主管一項任務需要多少干預。我會用這些數字來選擇要測試的內容,而不是放棄測試。
本次 SWE-2 審查的侷限性
這是一個記錄在案的評估計劃,而不是完整的獨立運行。它無法報告特定代碼倉庫的解決率、成本、掛鐘時間或 SWE-2 故障模式。結果將因所選 Devin 產品表面、工作量級別、工作區快照、代碼倉庫説明、依賴項可用性、網絡訪問、權限和任務簡介的質量而異。
它也不提出法律、安全、合規或購買聲明。在連接私有代碼倉庫之前,我會讓帳户所有者驗證當前的產品文檔和協議。特別是,團隊應檢查授予的實際權限、當前數據控制、保留語言、計劃權利以及預期的 SWE-2 選項在其 Devin 環境中是否可見。本次審查的任何部分均不暗示 EvoX 或 Evomap 使用或集成 SWE-2。
常見問題解答
SWE-2 目前在 Devin 產品中的哪些位置可用?
Cognition 在 2026 年 9 月 10 日發佈的聲明中表示,SWE-2 可在 Devin Desktop 和 CLI 中使用,並將推廣到 Devin Web 和 Fusion。這是發佈時間聲明,而不是永久權利承諾,因此我會在依賴特定表面之前檢查當前的模型選擇器、發佈説明和計劃。
Devin 團隊可以限制 SWE-2 可以訪問哪些代碼倉庫嗎?
對於 GitHub 集成,Cognition 的當前指南表示,管理員可以授予 Devin 對所有代碼倉庫或選擇代碼倉庫的訪問權限,並且可以稍後更改該範圍。企業部署還記錄代碼倉庫權限。 Devin GitHub 集成指南 列出了涉及的更廣泛的讀寫權限,因此“選定的代碼倉庫”仍應被視為有意義的訪問授權,而不是被視為無害的切換。
Cognition 如何處理提交給 SWE-2 的代碼倉庫數據?
Cognition 的公共安全文檔應與客户的協議一起視為此問題的當前來源。目前的公開措辭稱,Cognition 會處理授權用户主動提供的數據,並表示默認情況下會關閉對客户數據的模型訓練,除非通過數據控制啓用;它單獨指出企業客户數據不用於訓練模型。它還以不同的方式描述保留和反饋或用户交互數據。因為這些是數據處理條款,所以我會驗證實時文檔和合同,而不是將此答案轉化為法律或合規結論。
用户可以為每個任務選擇 SWE-2 推理工作嗎?
Cognition 的公告將 SWE-2 中、高和最大描述為行為上不同的努力級別,但該公告本身並不保證每個 Devin 表面都允許每個用户為每項任務選擇每種努力。我會在測試中記錄實際的可選設置,並在接口或計劃未公開它時將其標記為不可用。訓練多個努力水平本身並不是通用的每任務控制的證據。
Cognition 提供 SWE-2 權重還是獨立 API?
該發佈公告通過 Devin 產品描述了 SWE-2,而不是可下載的權重或獨立的 SWE-2 推理 API。 Devin 擁有平台和工作流程接口,但這與已發佈的模型權重版本或通用模型 API 不同。根據本文審查的公開材料,兩者都不應該假設;需要其中任何一個的團隊應該直接詢問 Cognition。
往期文章:
- 對於模型能力與實際任務完成情況的另一個固定代碼倉庫比較,Muse Spark 1.3 智能體推理 檢查長期編碼工作的完成質量、人工干預、恢復、延遲和推理工作。
- 如果您想了解如何通過一個有界代碼倉庫任務來評估編碼智能體,T3 代碼審查 會遵循設置、會話控制、差異檢查和切換,而不會混淆接口與底層智能體。
- 從更廣泛的實際軟件開發角度來看,GPT-5.6 Sol 軟件開發案例研究 不僅關注代碼生成,還關注測試、實施證據、部署邊界和人工審查。
- 為了理解為什麼SWE-2基準測試結果仍然依賴於周圍的執行層,DeepSeekharness插件架構將模型功能與工具、會話、權限、插件和運行時控制分開。
- 為了保留失敗測試、重試、更正和最終代碼倉庫狀態背後的證據,LLM 智能體的確定性重播 解釋了智能體運行如何在任務結束後保持可重現和可審核。