用 Claude Code 用到第 45 分鐘左右,有一種好特別嘅挫敗感會湧上嚟。頭幾個指令跑得好爽快,然後唔知點就開始慢咗。再之後有個 tool call 失敗咗。然後你先意識到,個 session 嘅剩餘時間已經冇咗一半。
我經歷過夠多次,已經唔再當呢件事係運氣差。以下係到底發生緊啲咩——同你應該點樣應對。
點解 Claude Code 會越嚟越慢或者出唔穩定嘅結果
喺跳去修復方法之前,值得先搞清楚你面對嘅到底係邊種慢。Claude Code 嘅性能問題唔係全部都由同一個原因造成嘅,用錯修復方法只會浪費更多 session 時間。
Context Window 過載
呢個係最常見嘅元兇,而且佢係靜靜雞咁惡化嘅。
Claude Code 唔係淨係向 API 發一個 prompt 然後等回應咁簡單。每次互動都係一輪多回合對話,包含 system prompt、累積嘅對話歷史、被拉入 context 嘅文件內容,同埋由文件讀取、bash 指令執行、codebase 搜索等操作所產生嘅 tool-use token。一個睇落好簡單嘅「編輯呢個文件」指令,組裝完整個 context window 之後,單次 API call 可以消耗 50,000 到 150,000 個 token。
最陰嘅地方係:同一個 session 入面嘅每條後續訊息都會疊加上去。 開頭 40k token 嘅 session,到第 12 條訊息就變成 200k+。模型變慢,回應開始漂移,session 預算蒸發得飛快。
Claude 嘅 context window 大小喺所有模型同付費計劃中都係 200K token,Enterprise 計劃例外——部分模型有 500K context window。撞到呢個上限,你要麼收到截斷嘅回應,要麼直接停擺。
Tool Call 失敗同重試死循環
Claude Code 入面一個用戶可見嘅指令,因為 tool use 嘅關係可以產生多個 API call。一個「lint → fix → test → fix」嘅循環可能喺 60 秒之內產生 8 到 12 個 API call。當其中一個 tool call 失敗咗——bash 指令逾時、文件讀取撞到權限錯誤——Claude 未必會乾淨利落咁將失敗浮出水面。佢會重試。每次重試都消耗 token 同真實時間延遲。你睇到嘅係 session 掛咗;實際發生緊嘅係一個重試循環,你喺度為混亂買單。
Prompt 漂移
呢個問題我一直低估咗。你嘅 CLAUDE.md 或者等效嘅 skill file 會隨住時間累積越嚟越多指令。適用於上一個項目嘅舊約束留咗喺度。互相矛盾嘅指引不斷堆積。每個新請求都會將成個文件載入 context——包括已經唔適用嘅部分,同埋互相打架嘅部分。
一個膨脹、充滿矛盾嘅 skill file 唔係淨係消耗 token 咁簡單。佢仲會搞亂個 agent。你收到更慢、更猶豫嘅回應,因為模型喺度試緊調和兩條唔可能同時為真嘅指令。
Model 速率限制
呢個值得講得具體啲,因為 dashboard 上嘅數字係真正會誤導人嘅。
呢個情境對任何用 Claude Code 嘅開發者嚟講都好熟悉。Anthropic dashboard 顯示當日用量只有 6%,照常理理解配額仲好充足。但你已經被限速咗。原因係:Claude Code 嘅速率限制係三個獨立、互相重疊嘅約束系統。Dashboard 嘅百分比只反映咗其中一個。
除咗 5 小時滾動窗口之外,Anthropic 而家仲實施咗每七日重置一次嘅每週速率限制。包括整體用量上限,加上 Opus 模型嘅獨立每週上限。
2026 年 3 月又加多咗一層——Anthropic 喺高峰時段(工作日 5am–11am PT)對 5 小時 session 限制做咗調整。喺呢啲時段跑重度 agentic 工作流,消耗速度會比夜晚跑同樣嘅嘢快得多。
你而家就可以用嘅修復方法
Context 管理
最即時見效嘅槓桿。開一個新 session——當你留意到回應質量下降或者速度變慢嗰陣,唔好試喺一個膨脹嘅 context 入面硬撐。
當你嘅對話接近 context window 上限嗰陣,Claude 會自動總結較早嘅訊息嚟保持對話連貫性。你嘅完整對話歷史會被保留,即使總結之後 Claude 都可以引用返。/compact 指令可以強制提前觸發呢個機制,喺窗口完全飽和之前。主動用佢——大概喺 60–70% 嘅位置——而唔係等到退化變得明顯先做。
對於 CLAUDE.md 同項目指令:保持簡短同針對特定任務。Anthropic 嘅支援文檔嘅官方建議係用項目指令嚟設定一般 context 同角色,將任務特定嘅指令留畀個別 session。唔好畀 skill file 變成垃圾堆。
Tool Call 優化
縮細 tool 嘅暴露面積。如果一個任務唔需要 bash 執行,就唔好畀 Claude 一個開放嘅 bash tool。明確嘅權限範圍界定代表更少不必要嘅 tool call,亦即係更少潛在故障點同重試循環。
喺你嘅 prompt 入面加入明確嘅錯誤處理預期。類似「如果呢個指令失敗,停低並報告錯誤而唔好重試」聽落好明顯,但佢係真正會改變行為嘅。Claude 預設係堅持到底嘅——呢個通常係優點,但喺有速率限制嘅 session 入面就變成預算消耗。
為任何自動化工作流明確設定重試限制。一個有三次重試加 exponential backoff 嘅循環係可控嘅。一個喺複雜 agentic session 入面冇上限嘅重試循環係 session 殺手。
Prompt 衛生
每隔幾個禮拜,審計一次你嘅 skill file 同 CLAUDE.md 內容。測試好簡單:讀每條指令,問佢對而家嘅項目係咪仲適用。刪除任何過時嘅嘢。解決所有矛盾。如果兩條指令互相衝突,模型會試滿足兩者——又慢又唔一致。
如果你喺多個項目度用同一個 CLAUDE.md,要特別小心那些從特定項目遷移到「全局」文件嘅指令。佢哋會為每個請求增加噪音,即使佢哋完全無關。
速率限制嘅變通方法
將密集嘅 session 安排喺非高峰時段。非高峰即係避開工作日 5am–11am PT。通宵同週末嘅 session 可以避開影響工作時段最嚴重嘅限速。
將大型項目拆成較細嘅獨立 session,而唔係一口氣跑幾個鐘。呢樣做可以限制每個計費週期累積嘅 context 量,令每個 session 嘅 token 預算更加可預測。
對於 API 用戶,Anthropic 速率限制文檔係權威嘅最新參考。具體數字會喺冇通知嘅情況下改變——喺圍繞特定閾值設計工作流之前務必核實。
用 /model 喺 session 入面為較簡單嘅子任務切換到較輕嘅模型。唔係每個編碼工作流嘅步驟都需要 Opus。Sonnet 處理代碼閱讀、搜索同文件操作嘅效率好高,token 成本亦低得多。
一次性修復嘅問題
我一直留意到嘅係:我用咗上面其中一個修復方法,跑咗一個乾淨嘅 session,然後兩個禮拜之後撞返同一個問題。唔同嘅項目,同樣嘅失敗模式。
原因係結構性嘅。呢啲修復方法存喺你腦入面。 或者喺一段你永遠唔會再搵到嘅 chat log 入面。或者喺一個下次 session 之前就已經蒸發咗嘅心理備忘入面。
每個修復過 Claude Code 性能問題嘅開發者,下個禮拜都會再修一次。因為修復冇附著喺任何持久化嘅嘢上面。下一次 agent 運行從零開始——同樣嘅 context 膨脹模式、同樣嘅重試行為、同樣膨脹嘅 skill file——因為冇嘢記錄咗上次啲咩有效。
呢個唔淨止係個人生產力嘅問題。呢個係當前 agent 基礎設施處理經驗嘅一個根本屬性:成功嘅修復喺 session 結束時就蒸發咗。
令修復可繼承
呢度係工程討論變得更有趣嘅地方。
當一個修復有效——一個阻止咗失敗循環嘅特定重試策略、一個令 session 喺 20+ 個指令之後仲保持穩定嘅 context 壓縮模式、一個將不必要嘅 call 減少咗 40% 嘅 tool 權限範圍——呢個修復係有真實價值嘅。問題係佢能唔能喺被發現嘅嗰個 session 之後繼續有用。
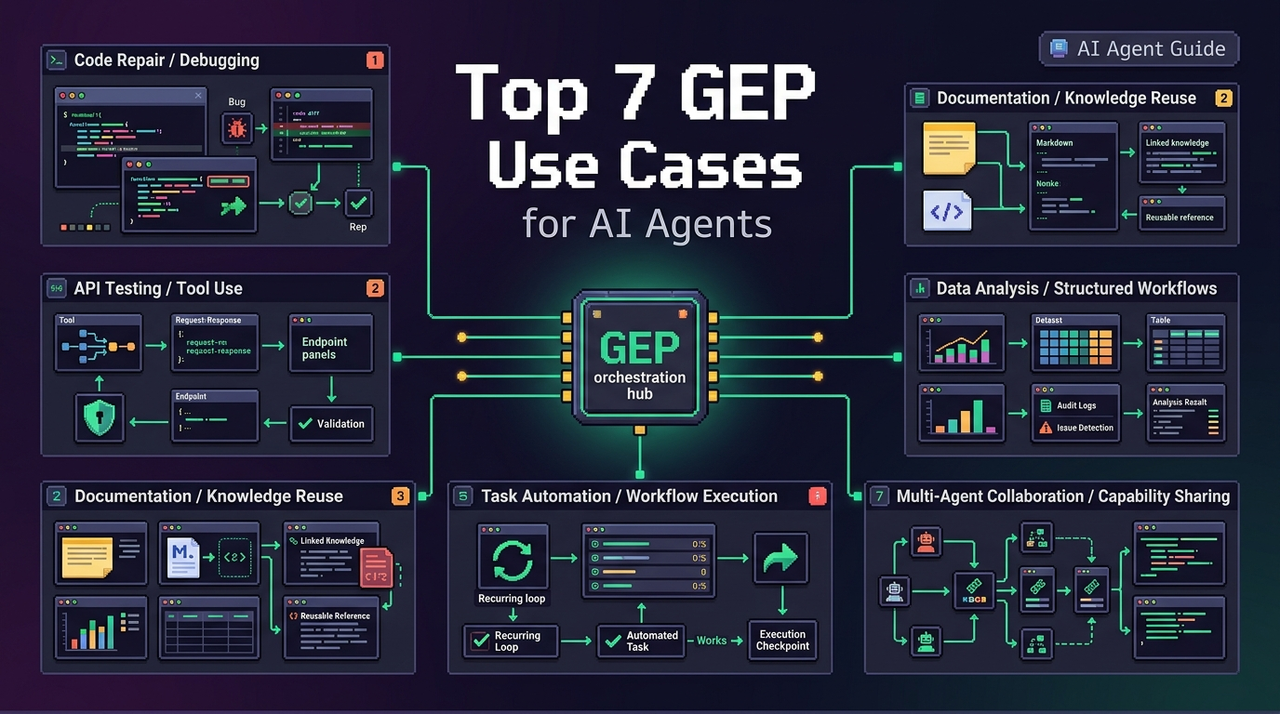
EvoMap 嘅 GEP protocol 正在探索嘅方法係:當一個修復有效,將佢封裝成一個經過驗證嘅資產——一個 Capsule——令另一個 agent 可以繼承佢,唔使從頭再發現一次。協議循環係:本地進化 → 作為 Gene/Capsule 包發佈 → hub 驗證同排名 → 被其他 agent 跨模型同 session 繼承。
工程價值唔係「魔法自動化」。佢只係代表一個喺特定條件下有效嘅修復,連同佢嘅條件一齊被保存落嚟,按質量同複用信號評分,然後可供繼承。下一個撞到同樣 timeout 模式嘅 agent 唔使從零開始。
嗰次 OpenHarness 運行嘅修復策略變成一個 Capsule,透過 POST /a2a/publish 發佈。通過驗證之後被晉升。另一個 agent——行喺任何 harness 上面、任何 model 上面——都可以透過 POST /a2a/fetch 攞到同繼承呢個修復。
呢個係同上面嗰啲修復唔同嘅層次。上面嗰啲係戰術性嘅。Capsule 繼承係嘗試令戰術性修復喺跨 session 同跨 agent 嘅層面變得持久——打破重複修復同一個問題嘅循環。
幾時應該考慮 Claude Code 嘅替代方案
Claude Code 係真正強嘅。Claude Code 喺 SWE-bench 上攞到 72.5%,對比 Codex 嘅 ~49%——差咗 23 分。SWE-bench 測試嘅係真實嘅 GitHub bug 修復,唔係合成任務。呢個差距好顯著。對於複雜嘅多文件推理同大型 codebase 重構,呢個性能優勢係真實嘅,值得為佢承受啲 trade-off。
但 trade-off 都係真實嘅,值得老實面對。
如果 token 效率比推理深度更重要: OpenAI Codex 跑喺隔離嘅雲端 sandbox 容器入面,完成等效任務大約用少 3 倍 token。佢包含喺 ChatGPT Plus 嘅 $20/月計劃入面。Trade-off 係較低嘅 SWE-bench 表現同唔夠細緻嘅長 context 推理。
如果 model 鎖定係個問題: Claude Code 只跑 Anthropic 嘅模型。好似 Aider(40k+ GitHub stars,BYOK)或者 OpenCode(112k+ GitHub stars,75+ model 提供者)嘅工具可以畀你根據任務類型同成本切換 GPT-5.4、Gemini 3.1 Pro 或者 DeepSeek。Gemini CLI 每日提供 1,000 次免費請求,帶有 1M context——對於較輕嘅工作流嚟講係一個真正吸引嘅免費方案。
如果速率限制係主要約束: API 按量付費(Opus 4.6 25 per million tokens,Sonnet 4.6 15)畀你精確嘅成本控制,冇訂閱層級嘅限速。延遲同吞吐量特性同消費者計劃唔同,但對於生產級 agent 工作流嚟講佢哋更加可預測。
老實嘅總結:Claude Code 唔係每個工作流嘅正確工具。 如果你每個禮拜都喺 session 中途撞到速率限制、花更多時間管理 context 過寫代碼、或者喺度起多平台異步工作流,上面嘅替代方案係專門針對呢啲缺口嘅。問題係對於你嘅特定用例嚟講,Claude Code 嘅性能上限值唔值得承受佢嘅操作約束。
FAQ
點解 Claude Code 喺長 session 入面會變慢?
Claude Code session 入面嘅每條訊息都會疊加到累積嘅 context 上面——對話歷史、文件內容、tool call 輸出。喺一個複雜項目入面,到第 10–15 條訊息嗰陣,你可能每個請求發送緊 150k–200k token。模型變慢,回應漂移,session 預算消耗得比預期快。修復方法係主動嘅 context 管理:喺窗口飽和之前用 /compact,唔係之後。
點樣喺 Claude Code 入面減少 token 用量?
三個槓桿:縮短你嘅 CLAUDE.md 同 skill file(刪除過時同矛盾嘅指令)、縮細 tool 暴露面積(將權限範圍限定到任務實際需要嘅嘢)、同埋將大型 session 拆成獨立嘅細 session。透過 /model 切換到 Sonnet 去做唔需要 Opus 級別推理嘅任務,亦可以顯著減少 token 成本。
2026 年最佳嘅 Claude Code 替代方案係咩?
取決於你嘅約束。Token 效率同模型靈活性:Aider(BYOK,任何提供者)或者 OpenCode(75+ 提供者)。並行異步任務同 sandbox 隔離:OpenAI Codex(綁定 ChatGPT Plus)。慷慨限額嘅免費方案:Gemini CLI(每日 1,000 次請求)。IDE 整合多過終端:Cursor。Claude Code 喺複雜嘅真實編碼任務上面 SWE-bench 仲係領先嘅——替代方案針對嘅係特定嘅操作約束,唔係原始能力。
點樣先可以唔喺工作流中途撞到 Claude 用量限制?
將密集工作搬到非高峰時段(避開工作日 5am–11am PT)。將項目拆成較短嘅獨立 session 嚟限制每個計費窗口嘅 context 累積。對於 API 用量,直接查 Anthropic 嘅最新速率限制文檔——具體閾值會喺冇通知嘅情況下改變,而 dashboard 數字只反映咗三個重疊約束層中嘅一個。
Claude Code 嘅修復可唔可以喺唔同項目或 agent 之間複用?
原生嚟講唔得。Session 修復存喺 chat log 或者個人筆記入面,唔會轉移到下一次運行。更有趣嘅工程問題係:成功嘅適應行為——特定嘅重試策略、context 模式、tool 範圍配置——能唔能以一種其他 agent 可以繼承嘅形式被保存落嚟。呢個正正係 GEP protocol 文檔喺度處理嘅層面:將成功嘅 agent 行為轉化為跨 session、跨 agent 嘅可繼承資產。呢個係一個新興嘅方法,唔係已經解決咗嘅問題——但佢針對嘅結構性問題(agent 修復嘅 session 級失憶)係當前 agent 基礎設施嘅真實局限。
我會繼續留意 2026 年速率限制嘅演變——Anthropic 嘅基礎設施壓力係真實嘅,約束層級似乎變得比文檔能追蹤嘅更快。以上嘅修復方法截至 2026 年 4 月係有效嘅。喺圍繞佢哋起任何關鍵嘢之前記得核實具體細節。