Veredicto rápido para uma tarefa de repositório
Esta revisão do SWE-2 não é uma afirmação de que executei o modelo de forma independente por meio de um repositório de produção. Não tenho um espaço de trabalho Devin com o mesmo repositório, permissões e condições de implantação que uma equipe de engenharia usaria. Em vez disso, estou apresentando a revisão de uma tarefa que gostaria de ver antes de tratar um modelo de codificação como pronto para o trabalho real do repositório.
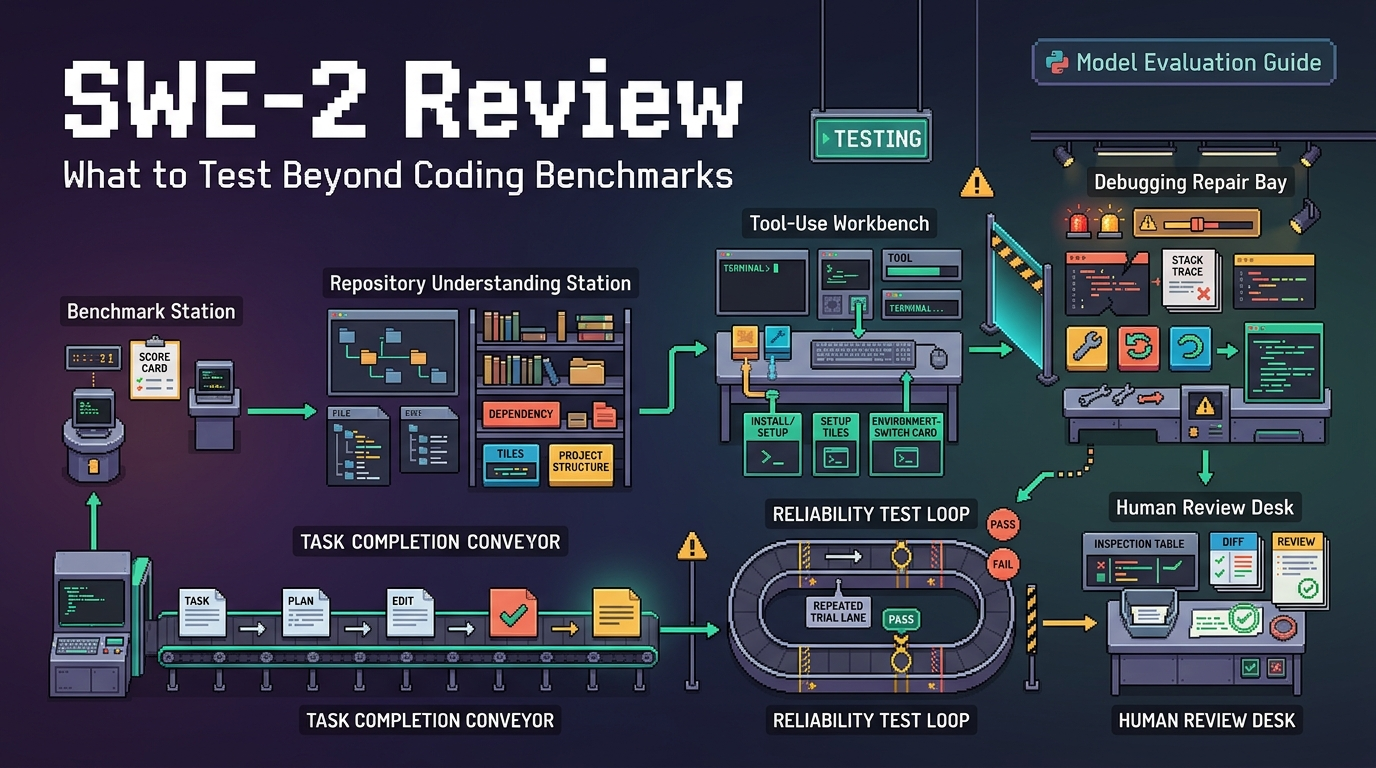
Eu sou Lena. Meu veredicto rápido é simples: parece que vale a pena avaliar o SWE-2 em Devin, mas um benchmark de codificação é apenas o começo da decisão. A questão útil não é se um modelo pode produzir uma correção plausível. É se ele consegue entrar em uma base de código desconhecida, encontrar os limites que importam, alterar a menor coisa certa, provar a mudança, recuperar quando seu primeiro caminho for interrompido e deixar algo que um ser humano possa revisar sem reconstruir toda a sessão.
Essa distinção é importante porque a Cognition relata resultados executados pelo fornecedor de 50,0% no FrontierCode 1.1 Main, 73,0% no DeepSWE 1.1 e 92,8% no Terminal-Bench 2.1. São sinais sobre a versão de 10 de setembro de 2026, e não taxas de sucesso reproduzidas de forma independente para o software de uma equipe. O mesmo anúncio de lançamento do SWE-2 diz que Desktop e CLI estavam disponíveis, com Web e Fusion sendo lançados. Eu testaria a superfície exata que uma equipe planeja usar.
Como eu testaria o SWE-2 em Devin
Para um teste real de agente de repositório, eu usaria uma alteração existente e não trivial, em vez de um prompt sintético ou uma solicitação ampla de recurso. Deve ser pequeno o suficiente para ser revisado de uma só vez, mas real o suficiente para exigir a descoberta de uma dependência e o respeito a um padrão estabelecido. Um bom candidato é um bug com um teste reprodutível com falha, uma alteração de validação com escopo restrito ou uma lacuna de comportamento documentada onde os critérios de aceitação podem ser verificados sem interpretação.
Antes de começar, eu registraria a superfície Devin, modelo selecionado, configuração de esforço exibida, data, commit SHA, regras de ramificação, arquivos de bloqueio, ferramentas, estado da rede e comandos iniciais de aprovação ou falha. Eu também definiria um orçamento de tempo e tentativa e salvaria todas as solicitações humanas após a tarefa de abertura. Isso evita que uma demonstração limpa se torne silenciosamente um experimento diferente.
Repositório, Tarefa, Ambiente e Critérios de Aceitação
O briefing deve nomear o comportamento, a área afetada e a linha de chegada: reproduzir o bug nomeado, fazer a menor alteração compatível, adicionar ou ajustar um teste de regressão, executar verificações prescritas e retornar uma comparação revisável. Ele não deve nomear um arquivo, a menos que um responsável normal saiba disso. Eu declararia os registros, segredos ou logins do navegador necessários com antecedência, em vez de confundir a falta de acesso com falha do modelo.
A linha de base precisa ser honesta. Se o repositório não for compilado antes da tarefa, eu salvaria os logs e distinguiria essa falha de uma falha criada pelo agente. Um subconjunto verde não conta se o comando de aceitação declarado permanecer vermelho. Instruções e testes locais podem orientar o modelo, mas pertencem ao registro.
O SWE-2 consegue entender a base de código antes de editar?
Eu inspecionaria o caminho, não apenas o código final. Uma sessão forte identifica o caminho de execução, testes relevantes, limites de configuração e convenções próximas antes de uma edição. Isso não recompensa a busca interminável. A cognição diz que o meio SWE-2 foi editado antes do SWE-1.7 nas execuções do FrontierCode; a velocidade só importa se as leituras ignoradas forem irrelevantes.
Encontrando restrições, dependências e padrões existentes
Eu perguntaria o que ele acredita que deve preservar: comportamento da API pública, tratamento de erros, autorização, formato dos dados, compatibilidade com versões anteriores ou uma convenção comparável. Então eu compararia essa resposta com o repositório. Ele encontrou o chamador real, usou o auxiliar de teste estabelecido e percebeu sinalizadores de recursos, artefatos gerados, migrações ou limites de pacote?
Esta parte de um teste real de agente de repositório deve produzir evidências, não uma pontuação para parecer confiante. Os artefatos úteis são os arquivos inspecionados, as restrições nomeadas e uma comparação cujo escopo corresponde a eles. Uma exploração surpreendentemente curta pode ser excelente; um longo ainda pode perder a dependência que torna um patch inseguro. Eu trataria edições inexplicáveis fora da área solicitada como uma descoberta de revisão, mesmo que os testes fossem aprovados.
O SWE-2 pode fornecer uma mudança verificada?
A implementação é onde um modelo de codificação SWE-2 deve se tornar responsável. Eu procuraria um patch mínimo, um teste de regressão que falharia sem ele e a saída do ambiente real do repositório. Para uma interface ou fluxo de trabalho, eu adicionaria uma verificação manual leve, em vez de presumir que a cobertura da unidade conta toda a história.
Implementação, testes e entrega final
A transferência deve dizer o que mudou, por que, o que foi executado e o que permanece incerto. Uma descrição limpa da solicitação pull não é uma prova. Eu executaria novamente o comando de aceitação de um novo checkout ou trabalho de CI, inspecionaria se há rotatividade não relacionada e confirmaria se a proteção da filial ainda se aplica.
Quero o mesmo padrão de qualquer colaborador: nenhum teste de aprovação inventado, nenhum serviço indisponível reivindicado como exercido e nenhum comando ignorado escondido em um resumo confiável. O Perfil de IA Generativa do NIST enquadra de forma semelhante a avaliação em torno do contexto e do risco, não de um rótulo de capacidade genérico. Não é um veredicto de aquisição para Devin ou SWE-2.
Onde a intervenção humana ainda é importante
A intervenção humana é uma medida. Este teste de agente de repositório real trata a intervenção humana do agente de codificação como um evento nomeado: uma pessoa esclareceu um requisito, concedeu a permissão esperada, reparou o ambiente, explicou uma convenção, escolheu entre comportamentos válidos do produto ou corrigiu um diagnóstico. Agregá-los em uma única contagem faz com que um agente pareça pior ou mais autônomo do que era.
Esclarecimento, testes com falha e recuperação
O momento mais revelador pode ser o primeiro teste que falhou após uma edição. Eu preservaria o diagnóstico, as evidências, a recuperação e se um humano forneceu um fato novo. A recuperação de falhas do agente de codificação é forte quando restringe a hipótese, inspeciona a falha, revisa o patch e executa novamente as verificações; é fraco quando altera repetidamente o código ou amplia a diferença.
Eu não fabricaria falhas apenas para tornar a sessão dramática. Mas quando um problema real de dependência, teste ou ambiente bloqueia a tarefa, ele pertence ao resultado. Para um agente de codificação, a qualidade da recuperação faz parte da qualidade da entrega. Ele me diz se um humano está revisando o trabalho ou se tornando silenciosamente o depurador do agente.
O que os benchmarks publicados não provam
Os benchmarks publicados podem mostrar que um modelo concluiu tarefas definidas sob um equipamento específico. Eles não estabelecem que ele entende sua arquitetura, tem suas permissões, inicializa seu conjunto de ferramentas, respeita seu processo de lançamento ou se recuperará da ambiguidade específica em seu ticket. Eles também não tornam SWE-2 e SWE-bench intercambiáveis: SWE-2 é o nome do modelo da Cognition, enquanto SWE-bench é uma família de benchmark.
Os números do fornecedor são especialmente fáceis de ler porque são precisos. Eles devem sempre levar sua fonte, versão de benchmark e data. Uma única pontuação não pode se tornar uma previsão do sucesso real do repositório, nem pode dizer ao líder de engenharia quanta intervenção uma tarefa exigirá. Eu usaria os números para escolher o que testar, não para dispensar o teste.
Limites desta revisão do SWE-2
Este é um plano de avaliação documentado, não uma execução independente concluída. Ele não pode relatar uma taxa de resolução, custo, tempo de parede ou padrão de falha do SWE-2 para um repositório específico. Os resultados variarão de acordo com a superfície do produto Devin selecionado, nível de esforço, instantâneo do espaço de trabalho, instruções do repositório, disponibilidade de dependência, acesso à rede, permissões e qualidade do resumo da tarefa.
Ele também não faz reivindicações legais, de segurança, de conformidade ou de compra. Antes de conectar um repositório privado, peço ao proprietário da conta que verifique a documentação e o contrato atuais do produto. Em particular, a equipe deve verificar as permissões reais concedidas, os controles de dados atuais, a linguagem de retenção, os direitos do plano e se a opção SWE-2 pretendida está visível em seu ambiente Devin. Nenhuma parte desta revisão implica que EvoX ou Evomap use ou integre SWE-2.
Perguntas frequentes
Onde o SWE-2 está disponível atualmente nos produtos Devin?
No anúncio de 10 de setembro de 2026, a Cognition disse que o SWE-2 estava disponível em Devin Desktop e CLI e estava sendo implementado em Devin Web e Fusion. Essa é uma declaração de tempo de lançamento, não uma promessa de direito permanente, então eu verificaria o seletor de modelo atual, as notas de lançamento e o plano antes de confiar em uma superfície específica.
Uma equipe Devin pode restringir quais repositórios o SWE-2 pode acessar?
Para a integração do GitHub, a orientação atual da Cognition diz que um administrador pode conceder acesso a Devin a todos os repositórios ou selecionar repositórios, e pode alterar esse escopo posteriormente. As implantações corporativas também documentam as permissões do repositório. O guia de integração Devin GitHub lista as permissões mais amplas de leitura e gravação envolvidas, portanto, o “repositório selecionado” ainda deve ser revisado como uma concessão de acesso significativa, não tratado como uma alternância inofensiva.
Como o Cognition lida com os dados do repositório enviados ao SWE-2?
A documentação de segurança pública da Cognition deve ser tratada como a fonte atual para esta questão, juntamente com a concordância do cliente. Seu texto público atual diz que o Cognition processa dados que um usuário autorizado fornece ativamente e diz que o treinamento do modelo em dados do cliente está desativado por padrão, a menos que seja habilitado por meio de controles de dados; afirma separadamente que os dados do cliente empresarial não são usados para treinar modelos. Ele também descreve retenção e feedback ou dados de interação do usuário de maneira diferente. Como estes são termos de tratamento de dados, eu verificaria a documentação e o contrato em tempo real, em vez de transformar esta resposta em uma conclusão legal ou de conformidade.
Os usuários podem escolher um esforço de raciocínio SWE-2 para cada tarefa?
O anúncio da Cognition descreve o SWE-2 médio, alto e máximo como níveis de esforço comportamentalmente diferentes, mas o anúncio por si só não promete que cada superfície Devin permita que cada usuário selecione cada esforço para cada tarefa. Eu registraria a configuração selecionável real no teste e a marcaria como indisponível se a interface ou plano não a expusesse. Treinar múltiplos níveis de esforço não é, por si só, evidência de um controlo universal por tarefa.
O Cognition fornece pesos SWE-2 ou uma API independente?
O anúncio de lançamento descreve o SWE-2 por meio de produtos Devin, não pesos para download ou uma API de inferência SWE-2 independente. Devin tem interfaces de plataforma e fluxo de trabalho, mas isso é diferente de um lançamento de pesos de modelo anunciado ou de uma API de modelo geral. Com base no material público revisado para este artigo, nenhum dos dois deve ser assumido; uma equipe que precisa de qualquer um deles deve perguntar diretamente à Cognição.
Postagens anteriores:
- Para outra comparação de repositório fixo entre a capacidade do modelo e a conclusão real da tarefa, raciocínio do agente Muse Spark 1.3 examina a qualidade da conclusão, intervenção humana, recuperação, latência e esforço de raciocínio no trabalho de codificação de longo horizonte.
- Se você quiser ver como um agente de codificação deve ser avaliado por meio de uma tarefa de repositório limitada, Revisão de código T3 segue a configuração, o controle de sessão, a inspeção de comparação e a transferência sem confundir a interface com o agente subjacente.
- Para uma perspectiva mais ampla de desenvolvimento de software real, estudo de caso de desenvolvimento de software GPT-5.6 Sol vai além da geração de código para testes, evidências de implementação, limites de implantação e revisão humana.
- Para entender por que os resultados do benchmark SWE-2 ainda dependem da camada de execução circundante, arquitetura de plug-in de chicote DeepSeek separa a capacidade do modelo de ferramentas, sessões, permissões, plug-ins e controle de tempo de execução.
- Para preservar a evidência por trás de testes, novas tentativas, correções e estado final do repositório com falha, reprodução determinística para agentes LLM explica como as execuções do agente podem permanecer reproduzíveis e auditáveis após o término da tarefa.