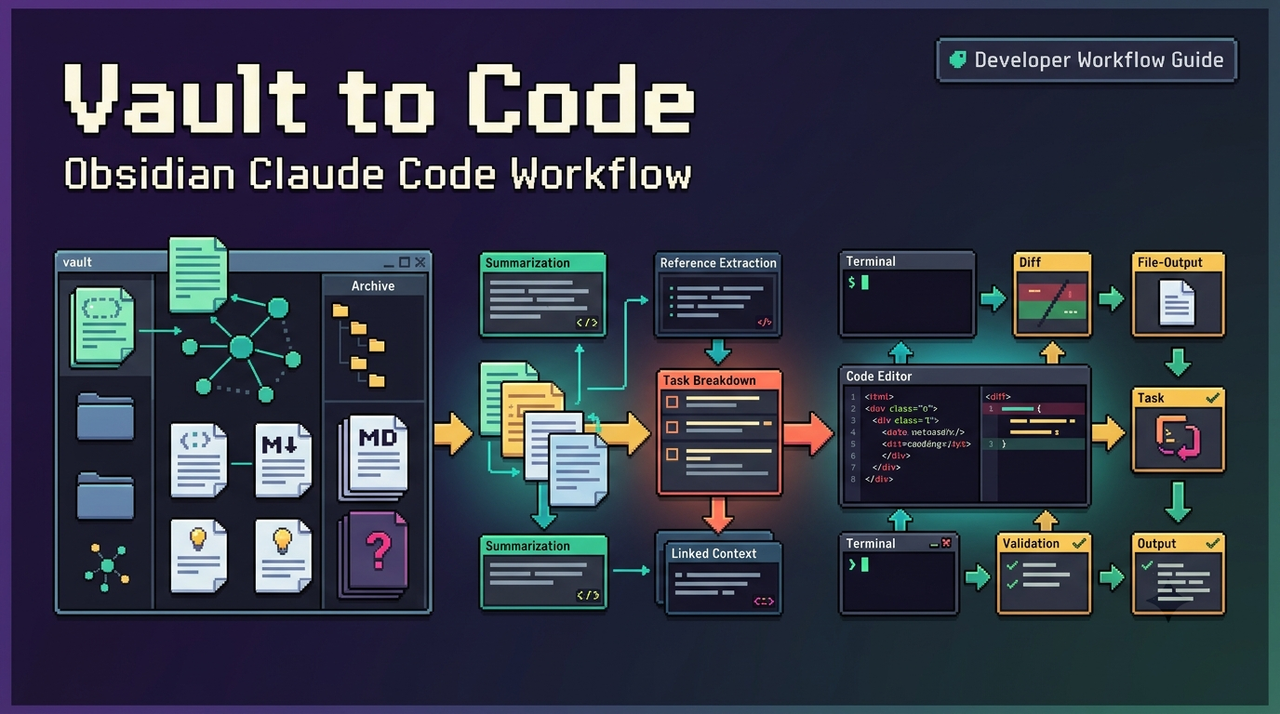
一个 Obsidian Claude Code 工作流程不需要将你的整个资料库变成“代理记忆”。我会让它保持更窄的范围:检索一条已批准的架构决策记录,在一个仓库中应用该决策,审查代码和测试证据,然后将一条实现笔记附加回 Obsidian。
那个界限很重要。Obsidian 可以是一个有用的编码代理知识库,因为源笔记保持可见且可编辑,而 Claude Code 可以在拥有自身权限和工作树控制的情况下操作存储库。风险部分在于,当检索悄悄变成不受限制的仓库访问,或者当一个代理在任何人检查实际更改内容之前就写回数据时。
我是莉娜。我在这里停下来是因为最干净的工作流程并不是最自动化的那个。它是每一次交接都清晰明了的那个。
| 阶段 | 代理访问 | 人类门 |
|---|---|---|
| 检索 | 通过范围限定的 CLI 读取一个 ADR | 确认准确的笔记和决策 |
| 应用 | 一个存储库或独立工作树 | 审查差异和验证 |
| 附加 | 仅审核过的证据 | 批准最终的保险库写入 |
定义从保险库到代码的任务
检索一个架构决策记录
从一个 ADR 开始,而不是“所有相关的项目背景”。假设有一个名为 Engineering 的虚构存储库,决策存储在 Architecture/ADR/ADR-0042.md。该代码仓库是一个位于 ~/work/acme-api 的独立虚构项目。
检索目标很简单:定位 ADR,读取其准确内容,并仅向 Claude Code 提供当前更改所需的决策。Obsidian 当前的 CLI 支持库定位、文件夹范围搜索、精确路径定位和文件读取。其文档还说明,当您明确定位库时,vault=<name-or-id> 必须出现在命令之前。
一个受控的查找可以是:
obsidian vault="Engineering" search query="ADR-0042" path="Architecture/ADR" format=json
obsidian vault="Engineering" read path="Architecture/ADR/ADR-0042.md"
在搜索后使用确切的 path=,而不是依赖短文件名,因为多个笔记可能解析为相同的名称。这是一个小细节,但它从保险库自动化中消除了令人惊讶的大量歧义。
添加一条已审核的实施说明
回写不应成为第二个独立的任务。它应该记录人类已经审核过的内容:应用了哪条ADR、哪个仓库变更代表它、进行了哪些验证,以及仍然存在的任何限制。
我不会让Claude从其自身叙述中“发明”证据。证据应来自可检查的仓库状态:最终的差异、测试输出,以及在适用情况下的提交标识符。笔记可以总结这些事实,但不应替代它们。
准备金库、存储库和命令行工具
在第一次写入之前备份保险库。将 ADR 文件夹与个人笔记、凭据、会议记录或 Claude 不需要的任何内容分开。对于此工作流程,我不会通过 Claude Code 的附加目录访问暴露整个保险库。相反,让 Obsidian CLI 执行特定的保险库读取,并将 Claude Code 保持在存储库中。
截至2026年9月3日,Obsidian 官方帮助说明 CLI 需要 Obsidian 1.12 安装程序,目前指定安装程序版本为 1.12.7 或更高版本。桌面应用程序也必须正在运行;如果它已关闭,第一个 CLI 命令会启动它。在发布命令之前,请检查当前的 Obsidian CLI 文档,因为 CLI 的行为正是那种我宁愿重新检查而不是默默假设的细节。
在 Claude 方面,从保守的权限模式开始。Anthropic 目前记录 default 会将编辑和大多数 Bash 操作置于审批之下,同时允许一组内置的只读命令而无需提示,而 plan 则用于在不编辑源文件的情况下探索代码库。权限规则也可以明确拒绝访问敏感路径。
这也与NIST 发布的代理工具使用分类中描述的访问模型一致,该模型在考虑代理系统时,将只读、受限写入和更广泛的写入访问分开。对于这个开发者知识工作流程,我宁愿授予的权限过少,然后批准一个额外的操作,也不愿默默地给一个编码代理访问它从未需要的文件夹。
在编辑代码之前检索上下文
第一个 Claude Code 提示应该是阅读任务,而不是实现任务。给它获取的 ADR,并要求用散文形式写出三件事:架构约束、可能受影响的仓库区域,以及任何应阻止编辑的不明确之处。
这就创建了一个有用的复习点。如果ADR规定所有出站HTTP调用必须使用共享重试策略,Claude不应立即更改五个客户端。它应首先确定出站调用的位置以及当前存储库使用的策略。
如果那个读数是错误的,就停在那里。如果是正确的,进入一个单独的编辑阶段。这就是计划模式发挥作用的地方:架构决策是背景,但它并不意味着可以更改所有与该主题相关的内容。
采取决定并收集证据
对于非平凡的更改,请将工作隔离。Claude Code 现在记录其自己的 --worktree 工作流程,而 Git 则将 worktree 定义为共享存储库历史记录的独立工作目录。
一个虚构的会议可以这样开始:
cd ~/work/acme-api
claude --worktree adr-0042-retry-policy
当前的 Git 工作树文档 值得保留在身边,当你需要独立于 Claude 检查、列出、修复或移除工作树时。
然后给Claude一个有界指令:仅在已识别的模块中实现ADR-0042,保留该范围之外的行为,运行仓库批准的验证,并报告所需的后续操作,而不是自行扩展任务。
证据应该以最好的方式无聊。阅读差异。检查已更改的文件列表。当更改重要时,自己运行或重新运行相关测试。如果有提交,请记录其标识符。
根据其当前文档,Claude Code 还会将对话数据本地保存为 JSONL 会话文件,并在更改之前对受影响的文件进行快照。我会将其视为用于恢复或回退会话的操作历史,而不是实现正确性的证明。
仅在人类审核后再写回
一旦实施通过审查,准备一份简短的证据说明。稳定的结构使后续检索更加容易:
ADR: ADR-0042
Repository: acme-api
Reviewed change: retry policy applied to outbound billing client
Evidence: reviewed diff; targeted tests passed
Commit: <reviewed-commit-id>
Open issue: none
Reviewed by: human
然后将其附加到已知的项目笔记中:
obsidian vault="Engineering" append \
  path="Projects/Acme/API/implementation-log.md" \
  content="\n## ADR-0042 implementation\nADR: ADR-0042\nRepository: acme-api\nEvidence: reviewed diff; targeted tests passed\nCommit: <reviewed-commit-id>\nReviewed by: human"
Obsidian 将 append 记录为将提供的内容添加到目标文件,同时 path= 可用于精确选择文件。写入后,读取一次笔记。最后一次读取成本很低,它可以在这些错误成为持久的项目知识之前捕捉到错误的保险库、错误的路径、引用或重复写入错误。
常见故障与恢复
第一个失败是目标错误的保险库。如果终端在一个保险库内,Obsidian 可以默认使用该保险库;否则可能会使用活动的保险库。对于这个工作流程,请明确指定 vault= 并将其放在第一位。
另一个失败是给予 Claude 超出任务所需的访问权限。不要仅仅因为一个 ADR 位于某个地方就添加整个 notes 目录。保持敏感路径禁止访问,谨慎批准 shell 调用,并在普通工作站上避免使用绕过权限模式。
工作树会添加它们自己的恢复边界。在恢复旧的编码会话之前,检查 git status 和 git worktree list。Claude Code 目前记录了自动工作树创建和清理行为,包括在有未完成更改时的不同处理方式,但我会在发布前再次核实这些细节,而不是将其视为永久政策。
重试也可能会重复实现说明。官方的 Obsidian CLI 文档并未将 append 描述为幂等操作。在进行第二次追加之前,请在目标笔记中搜索 ADR ID 或已审核的提交。
常见问题
黑曜石基地能为 Claude Code 提供结构化上下文吗?
是的,有条件地。Obsidian CLI 目前提供 base:query,文档化的格式包括 JSON、CSV、TSV、Markdown 和文件路径。如果你的工作流程传入该输出或允许相关命令,Claude Code 可以使用该输出。这不是官方文档的原生 Obsidian-Claude 集成,因此在将其视为权威上下文之前,请保持查询的范围有限并检查返回的内容。
插件生成的命令是否产生稳定的机器可读输出格式?
官方的 Obsidian 文档表示,CLI 可以列出插件注册的命令,并通过命令 ID 执行它们。我没有找到关于任意插件命令生成稳定可机器读取的模式的正式通用保证。除此之外我没有确信的答案,所以我会将输出契约视为插件特定的,而不是假设自动化的稳定性。
Claude Code 能通过 CLI 检索嵌入的 Canvas 内容吗?
当前的 CLI 参考文档没有记录支持 Canvas 的检索命令。Obsidian 文档确实说明 .canvas 文件使用开放的 JSON Canvas 格式。因此,访问原始文件为你提供了另一种可能的途径,但我不会声称 Obsidian CLI 目前能够为 Claude Code 执行嵌入 Canvas 内容的语义提取。
当 Claude Code 添加笔记时,wikilink 别名会被保留吗?
Obsidian 文档支持别名检查和内容追加操作,但我没有找到专门针对在追加过程中保持 wikilink 别名的公开保证。如果别名语法很重要,请追加精确审核过的文本,并立即读取目标笔记内容。
Obsidian 无头模式能在此工作流程中替代桌面应用吗?
并不是用作同一命令行工作流程的直接替代品。Obsidian 目前将 Headless 描述为一个针对包括 Sync 和 Publish 在内的服务的开放测试版独立客户端,而 Obsidian CLI 控制桌面应用程序。Headless 可以将同步的库放置在服务器上,以用于不同的基于文件的代理工作流程,但官方文档并未将其定位为桌面 CLI 命令界面的完整实现。(Obsidian)
结论
Obsidian Claude Code 的实用版本 deliberately 小:一个 ADR 出来,一个经过审查的代码更改发生,一个证据笔记返回。
这足以让 Obsidian 成为开发者知识工作流程的一部分,而无需假装存储库具有自主记忆,或赋予编码代理对项目知识的永久写入权限。保持存储库备份最新,保持权限严格,保持工作树可检查,并让人工审核成为唯一的回写路径。
这就是我暂时要说的。有趣的问题不是一个代理可以到达多少保险库,而是你可以给它多少的访问权限,同时仍能完成整个循环。
以前的帖子:
- 如果你想将此保险库到代码的流程与另一个编码代理控制界面进行比较,T3 代码审查 展示了如何在一个工作区中管理提供程序 CLI、权限模式、差异和 PR 交接。
- 关于将 Claude Code 连接到外部工具的权限方面,Claude Code MCP 安全 解释了为什么工具信任、范围访问、审批和敏感路径需要明确的边界。
- 为了避免将 Obsidian 笔记与真正的代理记忆混淆,代理工作流记忆 解释了可重用例程和验证经验与普通存储上下文的区别。
- 如果你想了解此交接背后的更广泛架构,AI 代理架构工具记忆规划 映射了规划、记忆、工具、编排、权限和恢复如何协同工作。
- 关于审查写回背后的证据层,面向 LLM 代理的确定性重放 展示了在文件读取、代码更改、测试、审批和最终成果周围应保存哪些记录。