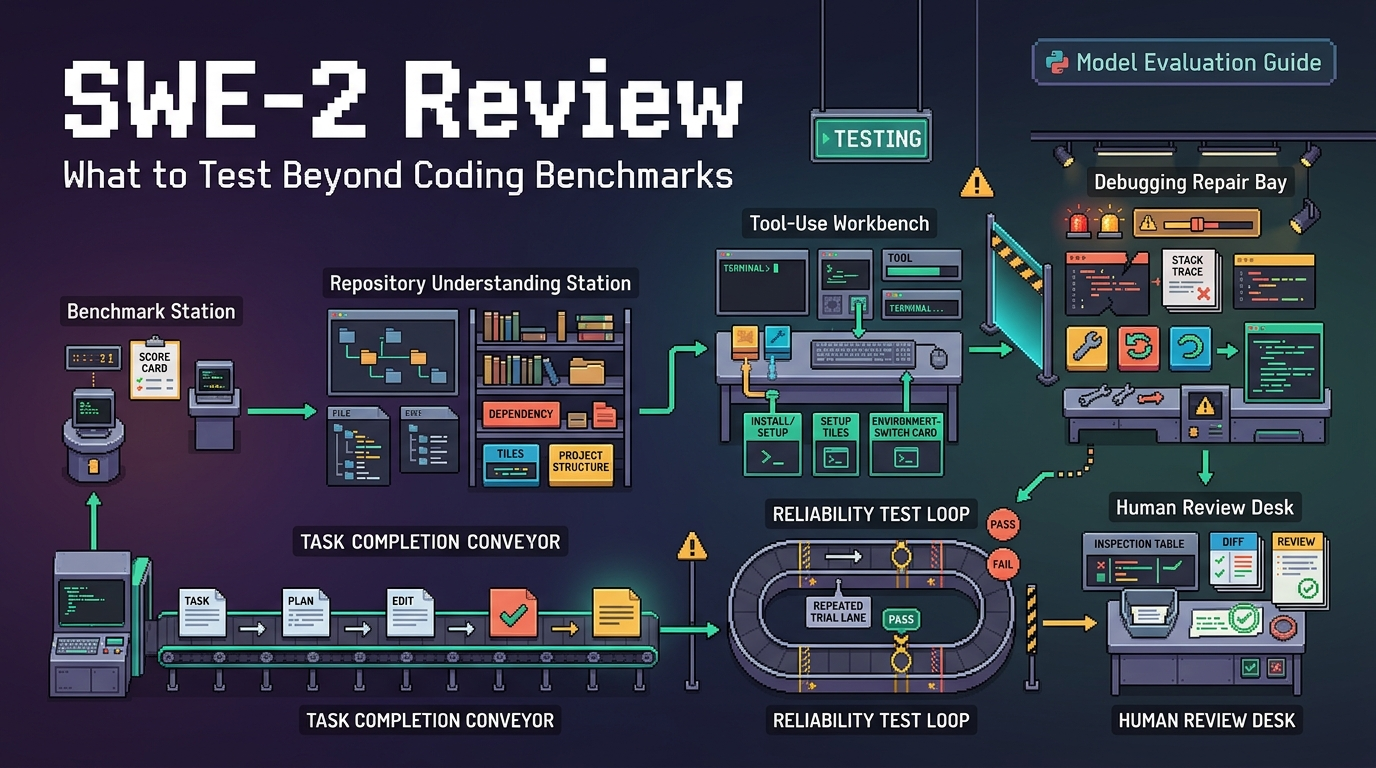
GPT-5.6 Sol 软件开发:解剖学案例研究
GPT-5.6 Sol 软件开发 在这里有趣的原因有一个:Anatomy 看起来像一个真实的应用程序,但仅凭一个公共仓库还不足以说明编码代理已经成为完整的软件构建者。我在这里暂停。更有用的问题更狭窄:这个案例实际上展示了什么关于将一个想法变成一个可维护的软件项目,我们仍然在哪里需要人工判断、工具、测试、资源和审查?
嗨,我是Lena。本文将thebuggeddev/anatomy视为一个可检查的案例,而不是预言。
解剖资料库实际上显示的内容
一个公共的 Three.js 解剖学浏览器
公共解剖学库 将该项目描述为一个使用 Three.js 和 GPT-5.6 Sol 构建的互动式 3D 人体解剖探索器。部署的 Anatomy Atelier 页面提供一个教育界面,包含器官卡片、旋转和缩放控制、标签、事实、课程、比较以及类似测验的互动。这已经不仅仅是一个玩具式的提示堆了。它有产品界面、组件结构、依赖栈和部署目标。
不过,我会对“构建”这个词保持谨慎。一个代码仓库可以展示代码、依赖项、测试和部署文件。它本身无法准确证明哪些代码行来自 GPT-5.6 Sol,哪些来自人工作者,哪些是从起始模板复制的,或者哪些资源来自外部的图像到 3D 工具。
仓库证据和未经证实的声明
可见的代码仓库证据支持一些有根据的陈述。它是公开的。它包含一个网页应用结构、README 文件、应用组件、测试、配置文件和包元数据。包文件列出了 Next、React、Three.js、GSAP、TypeScript、Vite 及相关工具。仓库页面还显示了公开的问题和拉取请求界面,以及提交历史。这告诉我们该应用以可检查的代码形式存在,而不仅仅是一个社交帖子。(GitHub)
它没有证明的东西更为重要。它没有证明自主的端到端构建。它没有证明模型设计了产品,选择了每个依赖项,生成了每个资源,审查了医疗内容,或在发布后维护了仓库。我不想过度解读我不完全理解的东西。
遵循一种软件构建路径
将产品创意转化为应用结构
对这个案例最强的解读是,人工智能软件开发者可以帮助将产品创意更快地转化为可运行的应用框架。Anatomy 的形态像一个小型教育产品:导航、器官库、互动标本区、信息面板、课程以及有状态的用户界面控件。这意味着该项目需要的不仅仅是“写一个 React 页面”。它需要一个能够承载视觉探索、学习内容和用户交互的应用结构。
对于开发者和技术创始人来说,这部分值得关注。编码代理变得有用,不仅在它们解决单独的问题时,而是当它们可以帮助塑造产品界面的初始版本时。这并不能取代产品品味。它只是改变了初步粗略结构的来源。
合并生成的资产、代码、测试和部署
一个解剖学3D应用程序不仅仅是代码。它可能还依赖于视觉资源、医学标签、用户界面文案、前端性能选择、交互设计以及部署配置。该代码库显示了构建和测试命令,包括npm run build和npm test,这一点很重要,因为当代码库留下可重复执行的命令而不仅仅是截图时,AI生成的软件会更容易获得信任。
这是模型结束、系统开始的地方。GPT-5.6 Sol 模型页面将Sol描述为用于复杂专业工作的旗舰模型,并列出了与编码相关的工具支持,如代码解释器、托管 shell、应用补丁、计算机使用、文件搜索以及通过 Responses API 的 MCP。这些功能在软件开发过程中可以提供帮助,但它们并不等同于产品所有权。仍然需要有人来决定什么算是正确、有用、安全、可访问和可维护的。
将结果作为维护的仓库进行审查
一个维护中的仓库需要与演示不同的审查方式。我会关注清晰的提交记录、问题处理、拉取请求审查、测试覆盖率、许可证文本、资产来源、可访问性说明、浏览器支持以及已知缺陷。Anatomy 给了我们一些可见信号,但并非全部。
对于一个由人工智能生成的软件项目来说,这是那个默默重要的无聊部分。第一次发布可能会令人印象深刻。到了第二周,会提出更艰难的问题:别人能否构建它、报告缺陷、提交修复、理解许可证,并信任内容边界?
模型的终点与系统的起点
工具、人类选择和外部资产管线
解剖案例很好地提醒我们,“GPT-5.6 编码”并不是单一的动作。一个模型可能会生成 React 组件、建议 Three.js 结构、编写 CSS、创建数据对象、起草标签或提出测试用例。但一个完整的应用程序还依赖于起始模板、软件包版本、部署服务、图像管道、3D 资源选择,以及人类决定保留哪些内容。
当我以这种方式看待这个案例时,某些东西略有变化。问题不再是“这是 AI 构建的吗?”,而变成了“软件构建循环中的哪些部分被加速了,哪些部分仍然需要审查?”对于评估 AI 编程代理的团队来说,这是一个更有用的问题。
测试、可访问性和领域审查
一款解剖学教育应用接近健康知识,即使它不是医疗产品。因此界限需要明确:解剖学应被视为教育材料,而非医疗建议。我在这里不评估医疗准确性。任何解剖学声明、标签、器官事实或临床说明在用于课堂、医疗环境或公众学习产品之前,都应由合格的主题专家进行审核。
可访问性也很重要。一个三维界面可以很美观,但在使用键盘导航、屏幕阅读器、减少运动设置或低端设备时仍可能难以使用。可见的代码包含一些以可访问性为导向的细节,例如 GitHub 展示的组件片段中的 ARIA 标签,但这与发布的可访问性测试报告并不相同。
关于人工智能构建的开源项目的经验教训
第一课是将公共源码与开源区分开。公共仓库允许人们查看代码。开源项目需要一个授予重用权利的许可证。如果许可证不明确,就不能假定可以进行商业重用。
第二课是归因规范。一个良好的 AI 构建的开源案例应该说明模型做了什么、人类做了什么、使用了哪些工具、以及资源来源。不是因为读者需要一部戏剧性的纪录片,而是因为可重复性取决于了解工作流程。
第三课是测试是产品的一部分,而不是事后的考虑。当仓库包含构建命令、测试、已知限制和问题跟踪时,AI 生成的软件会更有可信度。一张截图意味着“它曾经工作过一次”。有测试的仓库意味着“有人尝试让这个可以被检查”。
第四课是领域谦逊。对于教育、医疗、法律、金融或安全敏感的应用,模型的输出不是最终审核结果。它只是草稿材料。听起来不那么令人兴奋,但阅读起来更安全。
单一公共案例的限制
单一存储库可以显示可能性,而不是一般的未来。解剖学表明,AI 软件构建者可以帮助从一个想法组装出一个视觉丰富的应用程序,特别是当目标是前端教育体验时。这并不能证明 GPT-5.6 Sol 可以自主承担产品发现、医疗审查、无障碍合规性、资产许可、长期维护或安全响应。
我分享这个只是作为一种观察,而不是一种主张。对于创业者来说,实际的经验教训是通过成果物来评估编码代理:代码仓库结构、差异、测试、依赖选择、资源来源、问题历史以及部署行为。模型只是这一链条中的一个参与者。
常见问题
哪个存储库许可证管理解剖学代码的商业再使用?
在您查看仓库时,请使用仓库中显示的当前许可证。我在此次检查中没有在可见的 README 文本中找到明确显示的许可证。GitHub 的 许可指导 表示,如果没有许可证,则适用默认的版权规则,因此不应假设可以进行商业重用。这不是法律建议。
贡献者今天可以通过公共仓库提交修复吗?
该仓库公开了 GitHub 问题和拉取请求区域,但在提交之前应直接检查贡献政策。如果问题创建或拉取请求工作流程发生变化,目前的 GitHub 用户界面是权威来源。
哪些浏览器官方支持已部署的解剖学应用程序?
我在可见的已部署页面或自述文件中没有找到已发布的浏览器支持矩阵。团队在依赖该应用之前,应自行测试 Chrome、Safari、Firefox 以及移动浏览器。
该仓库是否发布针对3D控件的可访问性测试?
我没有找到正式的无障碍测试报告。可见标签很有用,但它们不能替代键盘、屏幕阅读器、对比度、动画和焦点测试。
已知的浏览器渲染缺陷在 Anatomy 中在哪里跟踪?
最安全的检查地点是存储库的公开问题区域。我在可见的项目资料中没有找到单独的专用浏览器渲染缺陷跟踪器。
这就是我目前对这个案例的结论:有趣的、可观察的、值得关注的,但不足以将一个精致的3D应用变成关于软件开发未来的普遍声明。
以前的帖子:
- 为了理解围绕 AI 软件构建者的系统,人工智能代理架构工具记忆规划 解释了模型、工具、记忆、编排和恢复如何塑造可靠的代理工作。
- 对于将一个想法转化为可运行项目的工作流程方面,人工智能代理工作流程逐步 展示了代理任务如何在计划、执行、验证和审查中流动。
- 如果你想通过更有力的证据评估人工智能构建的软件,LLM 代理的确定性重放 解释了在工具调用、文件更改、测试、工件和最终输出周围应保留哪些记录。