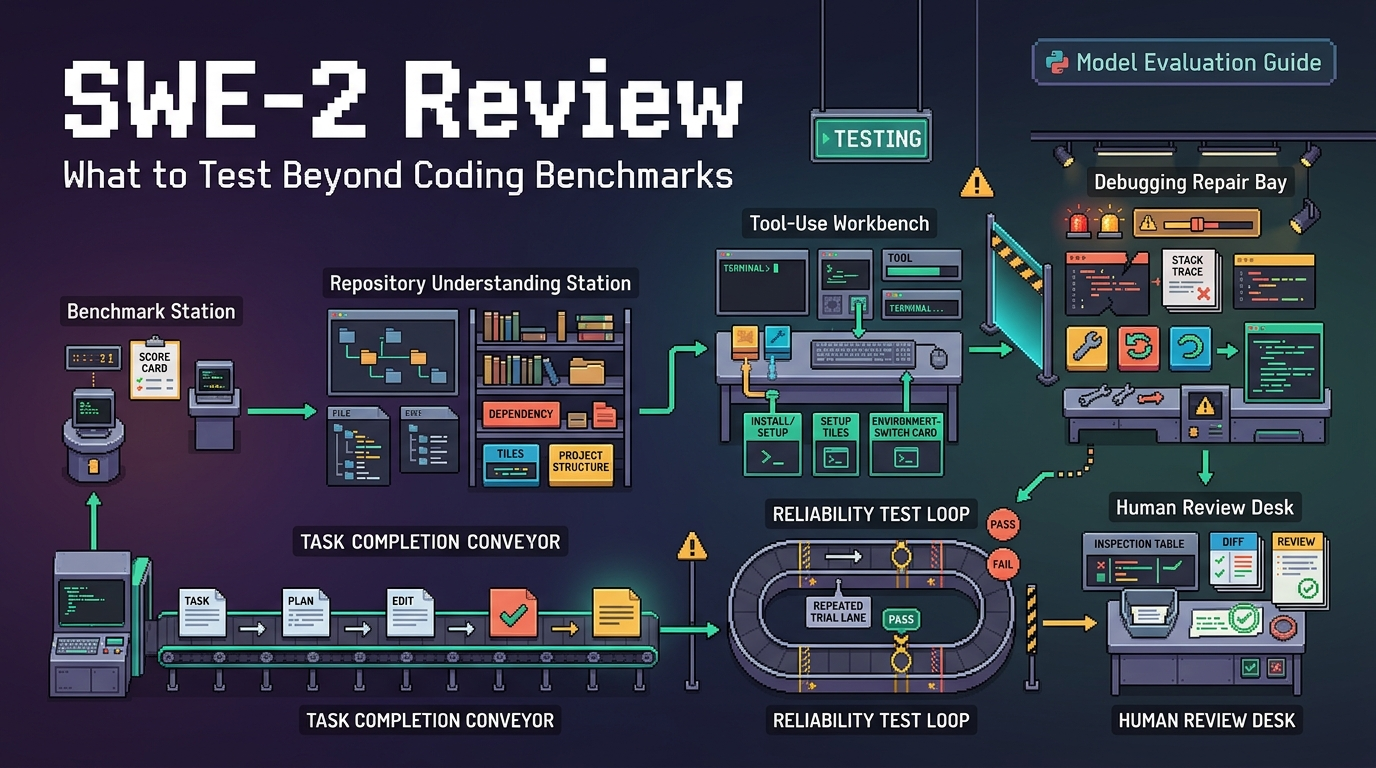
Sou Lena, e o que me fez parar foi a palavra max. A Meta diz que o Muse Spark 1.3 com raciocínio máximo está disponível no Muse Code e na Meta Model API, mas um nível maior de raciocínio não significa automaticamente um agente de programação melhor. A pergunta útil é mais específica: em uma tarefa longa de repositório, ele conclui mais trabalho com menos correções humanas, sem elevar a latência e o custo total além do valor da qualidade adicional?
Não tenho dados comparáveis de acesso e execução nos níveis padrão e máximo sob o mesmo ambiente fixo, então não vou apresentar isto como benchmark prático. É um plano de avaliação baseado nos materiais públicos atuais da Meta e nos controles que uma equipe técnica deveria registrar antes de decidir uma implantação.
Veredito rápido para uma tarefa longa de programação
Minha leitura atual é que vale testar o raciocínio máximo do Muse Spark 1.3, não presumir sua superioridade. O anúncio da Meta de 2 de setembro diz que o modelo foi treinado para trabalho agêntico e programação de maior duração, melhor retenção de instruções, autocorreção e busca de ajuda quando encontra dificuldades. A Meta também informa que, em comparações internas de engenharia com Muse Spark 1.2, a versão 1.3 usou cerca de 20% menos chamadas de ferramentas e 25% menos tokens. São ganhos geracionais relatados pelo fornecedor, não prova de que max supera um nível menor no seu repositório.
A distinção importa. A nota de lançamento do Muse Spark 1.3 confirma max e descreve melhorias do modelo; a página do modelo Muse o posiciona para fluxos agênticos prolongados e programação. Nenhuma fornece um experimento entre padrão e max com a mesma tarefa e ambiente que resolva a questão operacional.
Se max gera um patch mais completo com menos intervenção, o raciocínio extra pode ser útil. Se os dois níveis passam nos mesmos testes e max apenas demora mais ou consome mais recursos cobrados, fica mais difícil justificá-lo.
Defina a tarefa do repositório
Uma comparação de agentes de programação de longa duração acumula ruído rapidamente quando a tarefa é vaga. Eu escolheria uma mudança grande o suficiente para exigir planejamento, leitura de código, ferramentas e recuperação, mas pequena o suficiente para uma pessoa julgar o estado final.
Um exemplo é uma mudança funcional delimitada envolvendo um manipulador de API, a camada de validação e os testes: adicionar um campo opcional à requisição, manter compatibilidade retroativa, atualizar um serializador, incluir testes e não tocar arquivos sem relação. O agente pode inspecionar e editar o repositório, executar comandos de teste existentes e ler falhas. Não deve alterar CI, credenciais ou implantação sem permissão explícita na tarefa.
Escopo da mudança, testes e critérios de aceitação
Fixe o prompt antes de qualquer execução. Fixe também commit, ferramentas, ambiente, timeout, acesso à rede e comandos de teste. Os critérios devem ser iguais: testes relevantes passam, outros testes não regridem, a interface pública mantém compatibilidade, só arquivos autorizados mudam salvo necessidade e a resposta final explica alterações e verificações.
O objeto da avaliação é o estado do repositório, não a confiança do texto final. Revise diff, saídas dos testes, lint ou checagem de tipos e TODOs restantes. Se o agente diz “concluído” e existe uma regressão oculta, a tarefa está incompleta.
Compare o esforço de raciocínio na mesma tarefa
Execute o nível menor e max a partir do mesmo commit limpo, com prompt e ferramentas iguais. Se algum pedir um esclarecimento realmente necessário, forneça a mesma informação aos dois e registre a intervenção.
A comparação deve priorizar a conclusão: encontrou os arquivos certos, respeitou restrições, implementou a mudança, executou verificações adequadas, percebeu falhas, recuperou-se e deixou algo que um revisor poderia integrar? Uma execução max com plano sofisticado e três correções humanas não supera claramente outra mais simples que entrega um patch limpo.
Qualidade da conclusão e intervenção humana
Registre intervenções separadamente. Agentes de longa duração podem parecer capazes enquanto devolvem trabalho ao operador. Conte cada redirecionamento humano, explicação de algo que o agente poderia descobrir no repositório, reparo de ferramenta ou lembrete para executar um teste que deveria ter executado.
Separe aprovações necessárias de resgates. Aprovar uma ação importante é um recurso de segurança; resgatar o agente após editar o subsistema errado é uma falha de qualidade. Misturá-los faz uma configuração mais segura parecer pior.
É aqui que max pode ajudar: melhor retenção de restrições ou recuperação pode reduzir resgates. Mas eu precisaria ver o log antes de acreditar.
Latência, tokens e custo total da tarefa
Não compare apenas “tempo até a primeira resposta”. Um agente de programação opera em loop. Meça tempo decorrido até a aceitação, tokens do modelo, chamadas de ferramentas, chamadas com falha, novas tentativas, execuções de testes e tempo de espera humano.
Omito deliberadamente um preço numérico da API da Meta. Nesta pesquisa, não consegui verificar a tabela atual em uma página oficial acessível e não quero copiar um número de um catálogo secundário para um artigo voltado à produção. Antes de publicar, confira preços e limites vigentes da Meta para sua conta e região.
A fórmula útil é custo total da tarefa = uso do modelo + ferramentas ou sandbox + tempo do operador + custo de novas execuções. Max pode reduzir o custo por tarefa concluída se evitar tentativas e intervenções suficientes para compensar a diferença. O contrário também pode acontecer.
Separe ganhos do modelo do suporte do sistema
Sempre volto a este ponto: um agente Muse Spark 1.3 não é apenas Muse Spark 1.3. O modelo raciocina e escolhe ações; o sistema ao redor determina qual contexto permanece, quais ferramentas existem, como funcionam permissões, o que se repete e o que ocorre após falhas.
A Meta diz que o modelo foi treinado para pedir ajuda quando trava, preservar melhor instruções longas, resistir mais à injeção de prompts e confirmar ações importantes. Isso é útil, mas concluir tarefas ainda depende de manter estado do repositório, expor falhas dos testes, proteger credenciais, limitar arquivos e permitir recuperação sem perder o fio.
Estado, permissões e recuperação
Registre se cada execução consegue continuar após um comando malsucedido, se as saídas das ferramentas permanecem disponíveis, se distingue timeout de teste com falha e se volta ao último estado seguro após uma edição inadequada.
A segurança faz parte da mesma avaliação. Um modelo mais forte pode melhorar o julgamento, mas permissões determinísticas, credenciais de escopo limitado, aprovações, controles de rede e rollback continuam sendo responsabilidades do sistema. Ao ler alegações de segurança do fornecedor, lembre-se: comportamento do modelo e proteções do ambiente estão relacionados, mas não são a mesma coisa.
Algo mudou ligeiramente quando passei a olhar o lançamento assim. “Raciocínio máximo” deixou de parecer um veredito de produto e passou a ser uma variável dentro de um sistema controlado.
Limites e escolhas
Três limites permanecem visíveis. As alegações de eficiência de 1.3 contra 1.2 são do fornecedor e não respondem à comparação entre níveis menor e máximo. Benchmarks públicos podem evidenciar capacidade, mas ambientes, ferramentas, conjuntos de tarefas e raciocínio alteram resultados; eu não transformaria um ranking em SLA de produção.
Também não confirmei nas páginas revisadas um ID imutável de snapshot do Muse Spark 1.3, uma janela concreta de retenção para cada nível da Meta Model API ou um esquema completo de auditoria de raciocínio e ferramentas. São questões de contratação. Sem registrar a configuração exata, a equipe não consegue reproduzir a comparação depois.
Este artigo não implica que EvoX ou EvoMap integrem atualmente o Muse Spark 1.3. O método de avaliação aplica-se a sistemas de agentes de programação em geral.
Perguntas frequentes
Onde está disponível o Muse Spark 1.3 com raciocínio máximo?
O anúncio da Meta de 2 de setembro de 2026 informa disponibilidade no Muse Code e na Meta Model API. Ainda assim, eu verificaria acesso da conta e da região imediatamente antes de um teste de produção.
As equipes podem fixar um snapshot do modelo?
Não confirmei nas páginas atuais um compromisso público de fixação de snapshots imutáveis. Não presuma que o nome “Muse Spark 1.3” representa uma versão com data. Para reprodutibilidade, registre o identificador exato retornado pela API e pergunte à Meta se sua conta permite snapshot estável ou fixação de versão.
Quais controles de retenção se aplicam à Meta Model API?
As páginas públicas de lançamento e modelo que pude verificar não especificam uma duração concreta. Não a inventaria. Antes de enviar código proprietário, confirme no portal da Meta os termos atuais de uso e retenção para o nível exato da API e separe os termos do Muse Code dos da Model API diretamente.
Quais logs identificam o raciocínio e as ferramentas de cada execução?
As páginas da Meta revisadas não expõem um esquema completo para esta comparação. O ambiente deve registrar esforço solicitado, identificador de modelo retornado, ID da execução, tokens, nome da ferramenta, argumentos seguros ou hash, estado do resultado, duração, novas tentativas, aprovações e recuperação. A orientação de observabilidade GenAI do OpenTelemetry mostra como representar consistentemente chamadas de modelo, tokens e spans de ferramentas; o registro de conteúdo sensível de prompts e ferramentas deve continuar dependendo de adesão explícita.
Os controles da Meta podem pausar uma tarefa longa de programação?
A Meta diz que o Muse Spark 1.3 está mais bem calibrado diante de ações irreversíveis e pode pedir ajuda ou confirmação antes de etapas importantes. Isso favorece interrupções e aprovações, mas não deve ser tratado como garantia universal de pausa na API. Parada, aprovação, timeout e retomada precisam ser verificados no Muse Code ou no ambiente ao redor da Model API.
Para mim, a comparação de esforço de raciocínio deve terminar com um registro mostrando se concluiu mais trabalho, exigiu menos resgates e justificou latência e custo, não com “max vence”. Ainda não estou pronta para encerrar a questão com base apenas nas alegações do fornecedor. Uma tarefa fixa de repositório dirá mais.
Publicações anteriores:
- Confiabilidade do agente Claude Opus 4.7 examina outra questão de confiabilidade do modelo: por que raciocínio mais forte ainda exige evidências de conclusão, recuperação e revisão humana.
- Engenharia de ambientes de agentes de IA explica como ferramentas, estado, testes, memória, orquestração e avaliação moldam o desempenho real.
- Custo de implantação de agentes de IA detalha modelo, ferramentas, tempo humano, novas execuções e custo por entregável aceito para avaliar se max compensa.
- Fluxo de trabalho de agentes de IA passo a passo ajuda a projetar a tarefa fixa com planejamento, execução, validação, revisão e acompanhamento.