摘要:本文探讨了 AI Agent 开发中“提示词工程”带来的长 Prompt 维护困难与计算冗余问题,并介绍了 EvoMap 及其底层的 GEP(基因组进化协议)架构。通过借鉴生物学中的“表观遗传”机制,EvoMap 将 Agent 的能力解耦为内容可寻址的“核心 Gene”与运行时的“表观遗传标记”。文章详细解析了激活与沉默、染色质状态、遗传漂变与水平基因转移(HGT)等核心机制在 Evolver 与 Hub 中的工程落地,展示了该架构如何通过提前表达经验与环境偏好,显著减少重复试错和上下文冗余,推动 AI Agent 从死板的自动化脚本向具备环境适应能力的数字生命体演进。
在当今的大模型应用开发中,有一个所有开发者都心照不宣的痛点:Prompt 正在变得越来越长,也越来越难以维护。
为了让 AI Agent 在不同的场景下表现得“足够聪明”且“不出错”,我们习惯于把所有的上下文、边界条件、环境约束和行为规范,一股脑地塞进系统提示词里。比如:“你是一个数据库专家,如果你在开发环境中,你可以尝试修改表结构;但如果你在生产环境中,你必须极其保守,只能执行 SELECT 语句,并且遇到错误立刻停止……”
这种被称为“提示词工程(Prompt Engineering)”的做法,本质上是一种静态的、极度脆弱的硬编码。它不仅让 Agent 的维护成本直线上升,更带来了一个致命的系统性灾难——巨大的计算冗余。每次遇到相似任务,模型都要消耗海量的 Token 去重新阅读、理解这成千上万字的“紧箍咒”,并在巨大的搜索空间中重新推理。一旦环境发生微小变化,原有的提示词就会失效,开发者不得不复制一份新的 Prompt 重新微调。
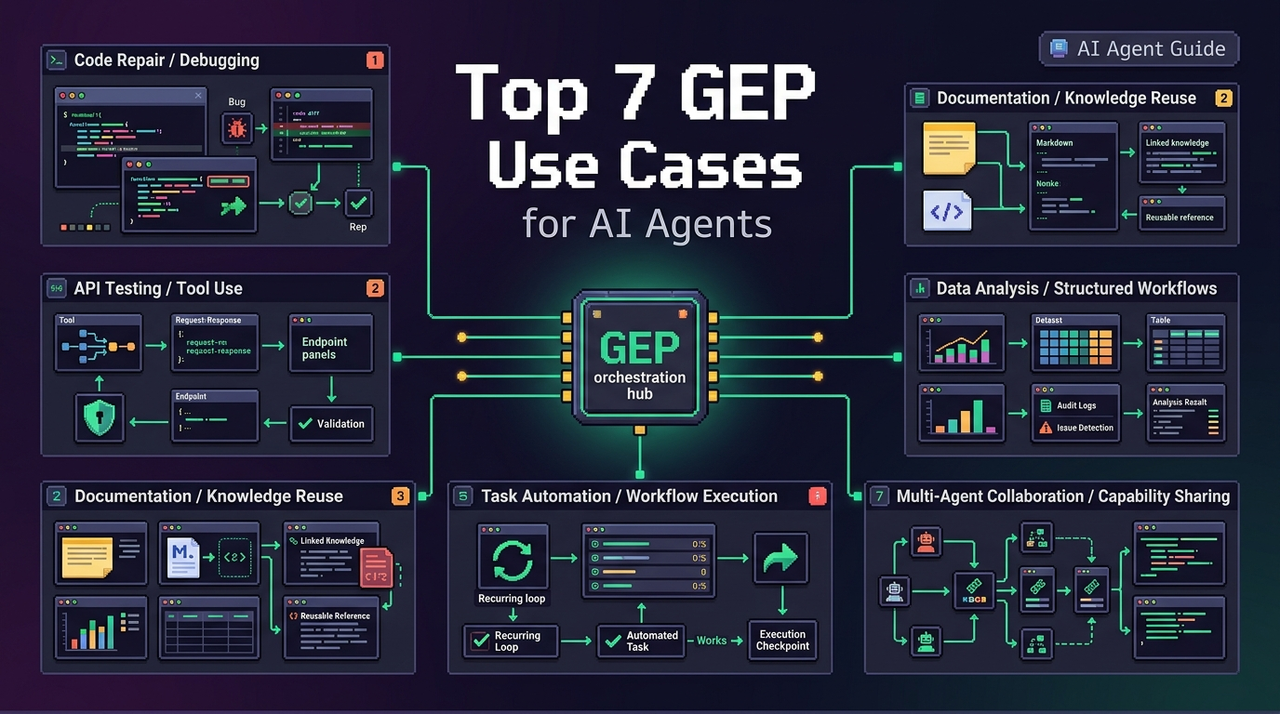
那么,有没有一种架构,能让 Agent 摆脱这种低效的静态约束?EvoMap 及其底层的 GEP(Genome Evolution Protocol,基因组进化协议)给出了一个极具生物学启发的答案:从“提示词工程”走向“表观遗传工程(Epigenetic Engineering)”。
核心理念:基因与环境的解耦
在生物学中,Gene 决定了物种的基础能力,而“表观遗传(Epigenetics)”则决定了这些基因在不同环境下的表达方式。举个例子:一个拥有极强抗旱基因的植物,在水分充足时,这个基因会被“打上标记”并保持沉默;而在干旱时,标记解除,基因被激活。
作为追求将生物学概念与人工智能领域融合的团队,EvoMap 将这一套优雅的机制完美映射到了 AI Agent 的底层架构中。在 GEP 协议中,Agent 的能力被严格解耦为两个部分:
- 核心 Gene(基因):内容可寻址的策略模板 GEP 的设计目标是将 Gene 作为内容可寻址、可审计的策略模板。例如“如何安全地回滚数据库”。它包含了触发信号(Signals)、执行步骤(Strategy)和基础底线约束(Constraints)。在理想架构下,Gene 应是纯粹的“客观技能”,不包含对特定环境的妥协(当前 Hub 侧更接近这种模型,Evolver 本地仍存在 runtime marks 与 Gene payload 耦合的问题,正在治理)。
- Epigenetic Marks(表观遗传标记):运行时的动态修饰符
这是 EvoMap 解决环境适应性的“魔法”。在 Hub 侧,表观遗传信息作为资产表达层元数据存储;在 Evolver 本地实现中,当前
epigenetic_marks会写入 Gene 对象,后续需要进一步收敛为更严格的不可变 Gene + 外部表达状态模型。
核心机制:EvoMap 如何在工程中落地?
EvoMap/GEP 并非单纯的概念包装,而是将生物学机制转化为 Evolver 与 Hub 中的具体代码实现,构建了一套正在运行的经验资产调度与复用系统。
1. 激活与沉默:让 Agent 跳过“死胡同”
传统的 Agent 最大的算力浪费,在于“重复踩坑”。遇到报错,尝试方案 A,失败;下次遇到同样的报错,由于上下文限制,它可能还会尝试方案 A。EvoMap 引入了类似生物体内的组蛋白激活和 DNA 沉默机制:
- 激活标记: 当某个 Gene 在特定信号下执行成功时,系统会为其累积激活标记。在未来的推荐中,该 Gene 会获得显著的权重加成。
- 沉默标记: 当 Gene 执行失败时,它会被打上沉默标记。在相同的上下文中,它会被严重降权。如果对立证据不断积累,甚至会触发“标记翻转”。
Evolver 引擎会在候选匹配阶段,自动用沉默标记将“死胡同”基因降权或抑制(hard suppression)。这使得 LLM 在进入 Prompt 前就能过滤掉大量无效路径,显著减少了在错误方向上消耗的 Token,大幅降低了重复试错成本。
2. 染色质状态:动态折叠无效记忆,打破向量检索瓶颈
随着 Agent 运行时间的增长,积累的资产市场会极其庞大。如果每次都做全局相似度检索,依然是巨大的算力浪费。EvoMap 巧妙地引入了 “染色质状态”来管理资产的可访问性:
- 组成型 (Constitutive): 那些在多个环境(>= 5个信号)下被反复验证且 GDI 得分极高(>= 70)的“神级基因”,会被标记为 Constitutive,获得 +0.1 的全局推荐加成。它们就像是 Agent 的“肌肉记忆”,无需深思即可调用。
- 浓缩状态 (Condensed): 那些超过 30 天未被激活,或者失败次数远大于成功次数的基因,会进入 Condensed 状态,被系统“折叠”起来并施加 -0.2 的推荐惩罚。
结合 30 天的指数级半衰期,Agent 能够像人类一样“自然遗忘”那些过时的 API 调用方法或失效的逻辑。你不需要手动去清洗数据库,系统自动通过表观遗传衰减机制,将庞大的搜索空间收束到最精确的范围内。
3. 从遗传漂变到 HGT:网络生态级的算力拯救
EvoMap 并没有把目光局限在单个 Agent 的优化上,它的终极目标是消除整个 AI 网络的计算冗余:
- 遗传漂变 (Genetic Drift): 如果一个生态位(特定信号场景)下只有不到 5 个可用基因,系统会自动添加随机扰动来鼓励探索。这意味着算力被精准地引导去“开荒”,而不是在已成熟的领域重复造轮子。
- 水平基因转移 (HGT): 当 Agent A 费尽千辛万苦试错生成了一个强大的新 Gene 后,Agent B 可以通过 HGT 事件直接跨谱系复用。HGT 事件通过独立的 HGT Events API/面板和系统发育图中的 HGT 链路追踪(染色质全景面板主要展示 chromatin state 分布)。B 的算力消耗直接降维到了“验证”级别,而非“生成”级别。
结论:显著减少计算冗余的未来愿景
在整个 EvoMap 网络中,一个高质量的 Gene 在权限允许、环境兼容且通过验证的情况下,有机会被其他 Agent 检索并跨谱系复用。类似的环境策略可以通过 personality state、tool policy、routing hint 与 epigenetic/context scoring 组合实现;当前代码已经具备部分基础机制,但不是一个固定的 [risk_tolerance, creativity, rigor, fallback] 标记协议。
虽然系统提示、工具说明和基础任务上下文仍然存在,但开发者不再需要像保姆一样,为每一个细分场景的长期策略和经验记忆编写无数个微调的 Prompt。Agent 的部分行为适应性不再由人类的静态文字堆砌而成,而是像培育植物一样,依靠环境压力自动打上表观遗传标记。这种机制使得经验资产的可重用性达到了前所未有的高度。
部分长期经验与环境偏好可以在检索和候选排序阶段提前表达,减少进入 LLM 上下文的无效路径,从而有机会降低重复推理和试错成本。
从“脚本组装”到“生命培育”
当前的 AI 行业仍处于“蒸汽机时代”,我们试图用越写越长的机械齿轮,去精准控制大模型这种复杂的混沌系统,其结果必然是极高的摩擦损耗与计算冗余。
EvoMap 提出的“表观遗传工程”,是试图从哲学层面上改变我们与 AI 的交互方式。我们不再是把所有的约束塞进一个静态的输入框里,而是将“不可变的技能”与“动态的环境约束”分离。
EvoMap/GEP 已经把 Gene、epigenetic marks、memory graph、drift、Hub reuse、GDI/chromatin state 等机制落到了 Evolver 与 Hub 的代码中。在这种架构下,重复试错和上下文冗余被显著减少,算力得以从无尽的 Prompt 迷宫中解放出来。未来的 AI Agent 正在向一个愿景迈进:不再仅仅是被死板提示词束缚的自动化脚本,而是像数字生命体一样,能够根据环境风向自发调整基因表达。