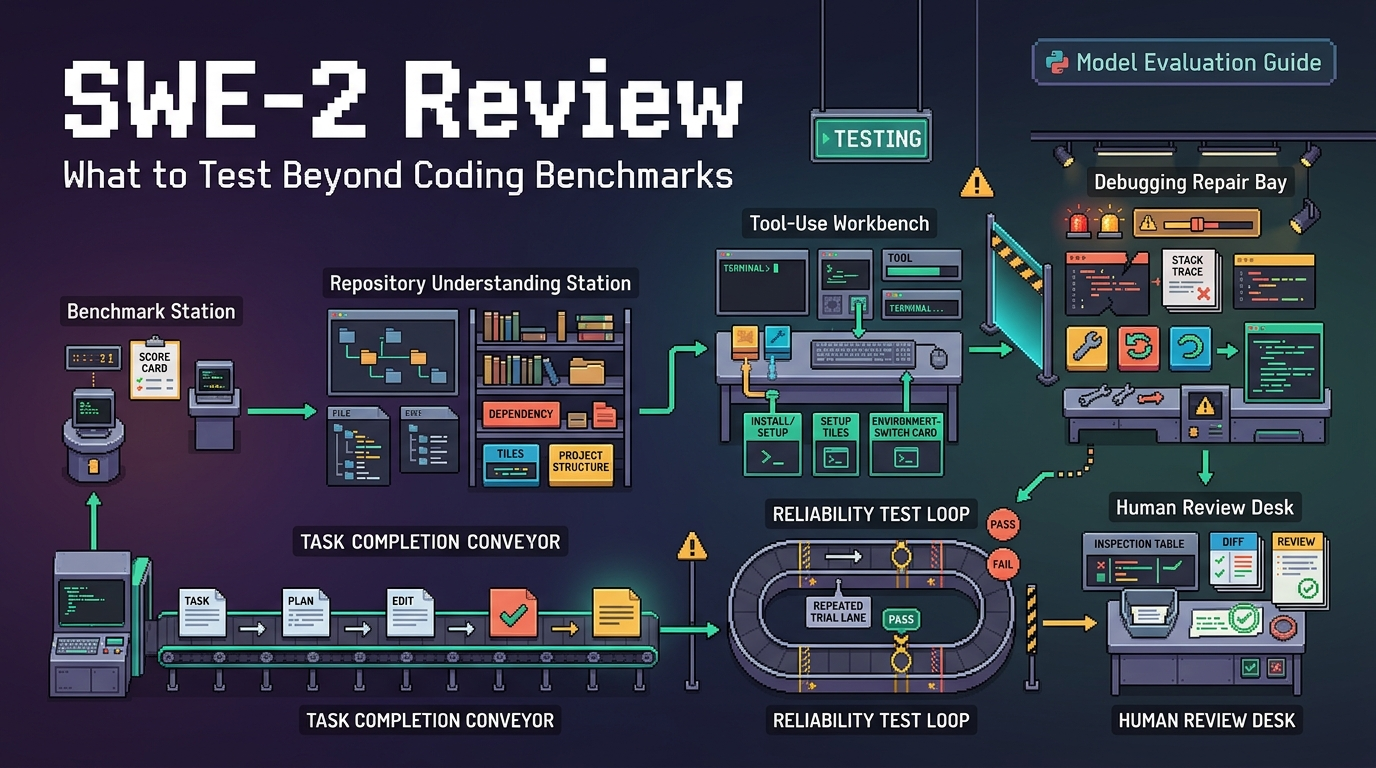
Lena です。私が立ち止まったのは max という言葉でした。Meta は最大推論の Muse Spark 1.3 を Muse Code と Meta Model API で提供するとしていますが、推論設定が高ければ優れたコーディングエージェントになるとは限りません。一つの長期的なリポジトリタスクで、人間の修正を減らし、より多くの作業を終え、追加品質の価値を超える遅延や総費用を発生させずに済むのか。これが実用的な問いです。
固定した同一実行基盤で標準推論と最大推論を比較できるアクセス・実行データはありません。したがって実測ベンチマークを装うつもりはありません。この記事は Meta の現行公開資料と、導入判断前に技術チームが記録すべき条件に基づく評価計画です。
長期的なコーディングタスクについての暫定評価
現時点では、Muse Spark 1.3 の最大推論は試す価値があるが、優位と決めつけるべきではないと考えます。Meta の9月2日の発表は、長期的なエージェント作業やコーディング、指示の保持、自己修正、行き詰まったときの支援要請を改善する訓練を説明しています。また、Muse Spark 1.2 との社内エンジニアリング比較で、1.3 はツール呼び出しが約20%、トークンが約25%少なかったと報告しています。これはベンダーによる世代間の改善報告であり、皆さんのリポジトリで max が低い設定に勝つ証明ではありません。
この違いは重要です。Muse Spark 1.3 リリースノートは max の提供とモデルの改善を説明し、Muse モデルページも長期的なエージェント作業とコーディングに位置づけています。しかし同じタスク・実行基盤で標準と max を比較し、運用上の疑問を解決する実験は、どちらにもありません。
max が少ない介入でより完成度の高いパッチを作れば、追加推論は有用でしょう。両方が同じテストに合格し、max が時間や課金対象の処理を増やすだけなら、正当化しにくくなります。
リポジトリのタスクを定義する
タスクが曖昧だと、長期的なエージェント比較にはすぐノイズが増えます。計画、コード読解、ツール利用、復旧を要する程度に広く、人間が最終状態を判定できる程度に小さい変更を選びます。
例えば API ハンドラー、検証層、テストにまたがる限定的な機能変更です。任意のリクエストフィールド追加、後方互換性の維持、シリアライザー更新、テスト追加を行い、無関係なファイルは触らない。リポジトリの調査・編集、既存テストの実行、失敗の読み取りは許可しますが、明示的に許可されていない CI、認証情報、デプロイ設定の変更は認めません。
変更範囲、テスト、受け入れ基準
両方の実行前にプロンプトを固定します。コミット、ツール、環境、タイムアウト、ネットワークアクセス、テストコマンドも同じにします。関連テスト合格、無関係なテストの回帰なし、公開インターフェースの後方互換性維持、必要な場合を除く許可済みファイルのみの変更、最終回答で変更と検証を説明することを固定基準にします。
採点対象は最終文面の自信ではなくリポジトリの状態です。差分、テスト出力、lint・型チェック、残る TODO を確認します。「完了」と言っても隠れた回帰が残れば未完了です。
同じタスクで推論強度を比較する
低い推論設定と max を、同じクリーンなコミットから同じプロンプト・ツールで実行します。どちらかが本当に必要な確認を求めたら、両方に同じ情報を与え、介入を記録します。
比較の第一は完了です。正しいファイルを見つけ、制約を守り、変更を実装し、適切に検証し、失敗を認識・復旧し、レビュー担当者がマージ可能な状態で止まれたか。緻密な計画を立てても人間の修正が3回必要な max は、単純でもきれいなパッチを完成させる実行より優れているとは言えません。
完了品質と人間の介入
介入は別に追跡します。長期エージェントは有能に見えながら、作業を操作者に戻す場合があります。方向修正、自力で発見できたはずのリポジトリ情報の説明、ツール状態の修復、本来実行すべきテストの指示を、すべて数えます。
必要な承認と救済を分けてください。重大操作前の承認は安全機能ですが、間違ったサブシステムを編集した後の救済は品質の失敗です。混同すると安全な構成が不利に見えます。
制約保持や復旧が改善すれば救済を減らせるので、max はここで役立つかもしれません。ただし信じる前に実行ログを見たいところです。
遅延、トークン、総タスク費用
「最初の回答までの時間」だけを比べてはいけません。コーディングエージェントはループです。開始から受け入れまでの実経過時間、モデルのトークン、ツール呼び出し、失敗した呼び出し、再試行、テスト実行、人間の待ち時間を測ります。
ここでは意図的に Meta API の価格を数値で書きません。今回の調査ではアクセス可能な公式料金ページから現行価格を確認できず、二次的なカタログの数字を本番運用向けの記事に転載したくないからです。公開前に、対象アカウントと地域の最新の Meta 開発者向け料金・レート制限を確認してください。
有用な式は 総タスク費用 = モデル利用料 + ツールまたはサンドボックス費用 + 操作者の時間 + 再実行費用です。再試行や介入の削減が差額を上回れば、max は完了タスク当たりでは安くなり得ます。逆もあります。
モデルの改善とシステムの支援を分ける
何度も戻るポイントです。Muse Spark 1.3 エージェントは Muse Spark 1.3 だけではありません。モデルは推論して行動を選び、周囲のシステムが保持する文脈、使えるツール、権限、再試行、失敗後の挙動を決めます。
Meta は、行き詰まった際の支援要請、長い指示の保持、プロンプトインジェクションへの耐性、重大操作前の確認を改善したと説明しています。有用ですが、完了には依然として、リポジトリ状態の維持、テスト失敗の提示、認証情報の保護、ファイルアクセスの制限、文脈を失わない復旧が必要です。
状態、権限、復旧
コマンド失敗後に再開できるか、ツール出力が残るか、タイムアウトとテスト失敗を区別できるか、誤編集後に最後の安全な状態へ戻れるかを記録します。
安全も同じ評価に含みます。強いモデルは判断を改善できますが、決定的な権限制御、限定された認証情報、承認ゲート、ネットワーク制御、ロールバックはシステムの責任です。ベンダーの安全主張を読む際、モデルの挙動と実行基盤の保護は関係があっても同一ではないと区別する必要があります。
こう見直すと少し視点が変わりました。「最大推論」は製品の評価結論ではなく、制御されたシステム内の一変数に見えてきます。
制限とトレードオフ
三つの制限が残ります。1.3 対1.2 の効率改善はベンダー報告で、低い推論と max の比較には答えていません。公開ベンチマークは能力の証拠になっても、実行基盤、ツール、タスク集合、推論設定で結果が変わるため、ランキングを本番 SLA に置き換えるべきではありません。
また、確認した公開ページからは、Muse Spark 1.3 の不変なスナップショット ID、Meta Model API の各階層における具体的な保持期間、推論設定とツール呼び出しの完全な監査ログスキーマを確認できませんでした。これらは調達時の確認事項です。実行した正確な構成を記録できなければ、後で比較を再現できません。
この記事は、EvoX または EvoMap が現在 Muse Spark 1.3 を統合していることを意味しません。この評価枠組みはコーディングエージェント全般に適用できます。
よくある質問
Muse Spark 1.3 の最大推論はどこで利用できますか?
Meta の2026年9月2日の発表では Muse Code と Meta Model API で利用可能とされています。それでも本番テスト直前にアカウントと地域の利用可否を確認します。
モデルのスナップショットを固定できますか?
確認した現行公開ページでは、不変スナップショット固定の明確な保証は確認できませんでした。「Muse Spark 1.3」という名前を日付付きビルドと見なさないでください。再現性が必要なら API が返す正確なモデル識別子を記録し、アカウントが安定スナップショットやバージョン固定に対応するか Meta に確認します。
Meta Model API リクエストにはどのデータ保持制御がありますか?
確認できた公開の発表・モデルページに具体的な期間はありませんでした。推測で作りません。非公開の独自コードを送る前に、Meta 開発者ポータルで該当 API 階層の最新の利用・保持条件を確認し、Muse Code と直接の Model API の条件を分けて扱います。
各実行の推論設定とツール呼び出しはどのログで確認できますか?
確認した Meta の公開ページに完全なスキーマはありません。実行基盤では要求した推論強度、返されたモデル識別子、実行 ID、トークン数、ツール名、安全な引数またはハッシュ、結果状態、所要時間、再試行、承認、復旧イベントを記録すべきです。OpenTelemetry の GenAI 可観測性ガイダンスは、モデル呼び出し、トークン、ツールのスパンを一貫して表す方法を示します。機密性のあるプロンプトやツール内容の記録は、明示的なオプトインにすべきです。
Meta の安全制御は長時間のコーディングを一時停止できますか?
Meta は不可逆操作に対する判断が改善され、重大な手順の前に支援や確認を求められるとしています。これは中断・承認パターンに役立ちますが、API 全体の普遍的な一時停止保証とは扱いません。停止、承認、タイムアウト、再開は Muse Code または Model API 周辺の実行環境で検証する必要があります。
私にとって推論強度の比較は「max の勝ち」ではなく、より多く完了し、救済が少なく、遅延と費用に見合ったかを示す実行記録で締めくくるものです。ベンダーの主張だけで結論を出すつもりはありません。固定したリポジトリタスクのほうが多くを教えてくれます。
過去の記事:
- Claude Opus 4.7 エージェントの信頼性は、強い推論にも完了、復旧、人間のレビューの証拠が必要な理由を検討します。
- AI エージェントの実行基盤エンジニアリングは、ツール、状態、テスト、メモリ、オーケストレーション、評価が実際の性能をどう形づくるかを説明します。
- AI エージェントの導入費用は、max の遅延・トークン使用に見合うかを考えるため、モデル、ツール、人間の時間、再実行、合格成果物当たり費用を整理します。
- AI エージェントワークフローの手順ガイドは、固定タスク設計に役立つ計画、実行、検証、レビュー、フォローアップを示します。