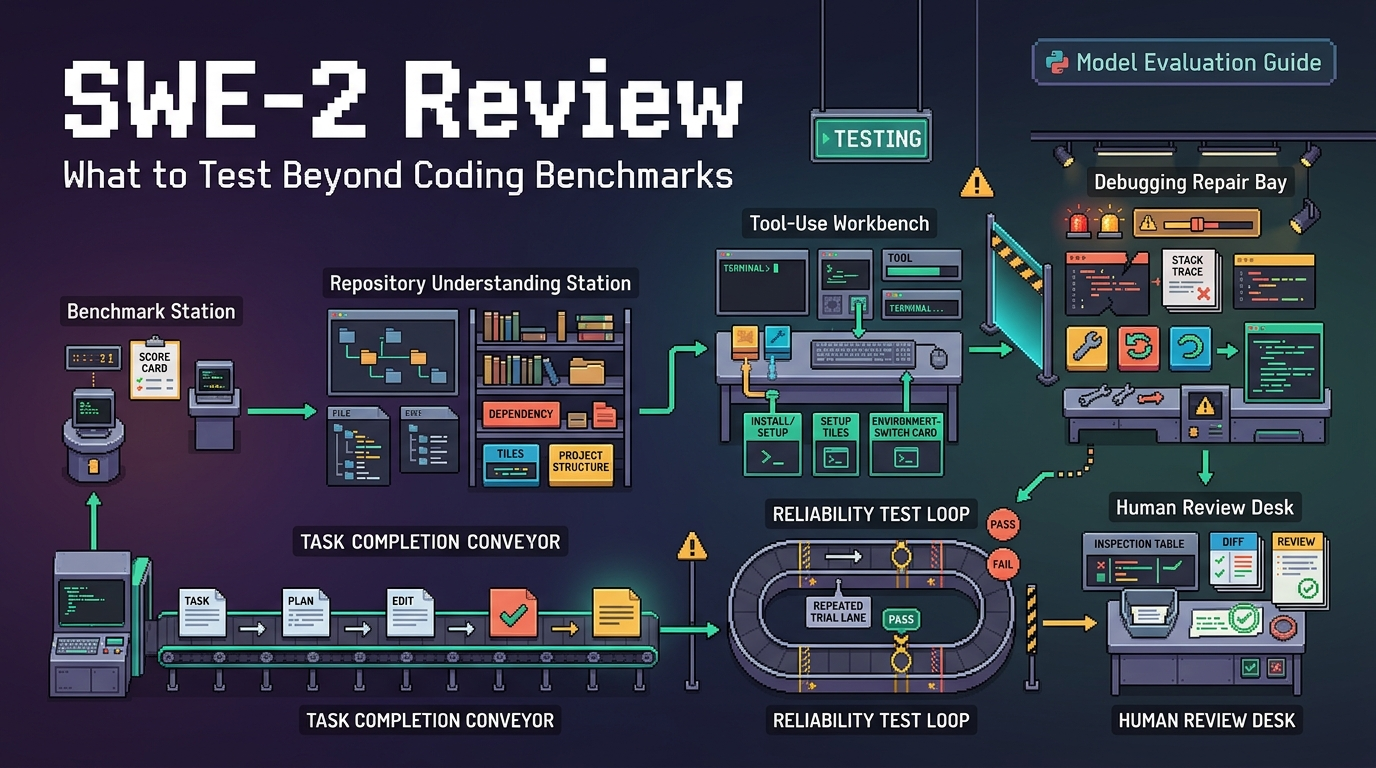
Soy Lena, y me detuve en la palabra max. Meta dice que Muse Spark 1.3 con razonamiento máximo está disponible en Muse Code y Meta Model API, pero un nivel más alto no implica automáticamente un mejor agente de programación. La pregunta útil es más concreta: en una tarea prolongada de repositorio, ¿termina más trabajo con menos correcciones humanas, sin que la latencia y el costo total superen el valor de la calidad adicional?
No tengo datos comparables de acceso y ejecución con razonamiento estándar y máximo bajo un mismo entorno fijo, así que no presentaré esto como una prueba práctica. Es un plan de evaluación basado en el material público actual de Meta y en los controles que un equipo técnico debería registrar antes de decidir un despliegue.
Veredicto breve para una tarea de programación prolongada
Mi lectura actual es que vale la pena probar el razonamiento máximo de Muse Spark 1.3, no darlo por mejor. El anuncio de Meta del 2 de septiembre dice que el modelo se entrenó para trabajo agéntico y programación de mayor duración, mejor conservación de instrucciones, autocorrección y solicitud de ayuda cuando se atasca. Meta también informa que, frente a Muse Spark 1.2 en comparaciones internas de ingeniería, la versión 1.3 usó aproximadamente 20 % menos llamadas a herramientas y 25 % menos tokens. Son mejoras generacionales reportadas por el proveedor, no evidencia de que max supere un nivel inferior en tu repositorio.
La distinción importa. La nota de lanzamiento de Muse Spark 1.3 confirma la disponibilidad de max y describe mejoras del modelo; la página del modelo Muse lo sitúa en flujos agénticos prolongados y programación. Ninguna ofrece un experimento estándar frente a max con la misma tarea y entorno que resuelva la cuestión operativa.
Si max genera un parche más completo con menos intervención, el razonamiento adicional puede ser útil. Si ambas configuraciones superan las mismas pruebas y max solo tarda más o consume más recursos facturados, resulta más difícil justificarlo.
Definir la tarea del repositorio
Una comparación de agentes de programación prolongados se llena de ruido si la tarea es vaga. Elegiría un cambio suficientemente amplio para requerir planificación, lectura de código, herramientas y recuperación, pero suficientemente acotado para que una persona juzgue el estado final.
Un buen ejemplo es una modificación funcional delimitada que abarque un controlador de API, validaciones y pruebas: agregar un campo opcional de solicitud, mantener compatibilidad hacia atrás, actualizar un serializador, añadir pruebas y no tocar archivos ajenos. El agente puede inspeccionar y editar el repositorio, ejecutar las pruebas existentes y leer fallos. No debería cambiar configuración de CI, credenciales ni despliegue salvo autorización explícita en la tarea.
Alcance del cambio, pruebas y criterios de aceptación
Fija el prompt antes de ejecutar cualquiera de las variantes. Fija también commit, herramientas, entorno, tiempo límite, acceso a red y comandos de prueba. Los criterios deben permanecer iguales: pasan las pruebas relevantes, no hay regresiones en otras pruebas, se mantiene la compatibilidad de la interfaz pública, solo cambian archivos autorizados salvo necesidad y la respuesta final explica cambios y verificaciones.
Se evalúa el estado del repositorio, no la seguridad con que está redactada la respuesta. Revisa el diff, las salidas de pruebas, lint o comprobación de tipos y los TODO pendientes. Si el agente dice “terminado” y queda una regresión oculta, no terminó.
Comparar el esfuerzo de razonamiento en la misma tarea
Ejecuta el nivel inferior y max desde el mismo commit limpio, con el mismo prompt y herramientas. Si alguno plantea una aclaración realmente necesaria, proporciona la misma información a ambos y registra la intervención.
Primero compara la finalización. ¿Encontró los archivos correctos, respetó las restricciones, implementó el cambio, ejecutó las verificaciones adecuadas, detectó fallos, se recuperó y dejó un estado que un revisor pudiera integrar? Una ejecución max con un plan sofisticado pero tres correcciones humanas no supera claramente a otra más simple que entrega un parche limpio.
Calidad de finalización e intervención humana
Registra la intervención por separado: un agente prolongado puede parecer competente mientras devuelve trabajo al operador. Cuenta cada redirección humana, explicación de un dato del repositorio que podía descubrir, reparación de un estado de herramienta o recordatorio de una prueba que debía ejecutar.
Separa las aprobaciones necesarias de los rescates. Aprobar una acción importante es una medida de seguridad; rescatar al agente después de que edite el subsistema equivocado es un fallo de calidad. Mezclarlos hace parecer peor una configuración más segura.
Aquí podría ayudar max: conservar mejor las restricciones o recuperarse mejor puede reducir rescates. Pero querría ver el registro antes de creerlo.
Latencia, tokens y costo total de la tarea
No compares únicamente el “tiempo hasta la primera respuesta”. Un agente de programación funciona en bucle. Mide tiempo transcurrido hasta la aceptación, tokens, llamadas a herramientas, llamadas fallidas, reintentos, ejecuciones de pruebas y tiempo de espera humano.
Omito deliberadamente una cifra de precio de la API de Meta. En esta investigación no pude verificar las tarifas actuales desde una página oficial accesible y no quiero trasladar números de un catálogo secundario a un artículo dirigido a producción. Antes de publicar, consulta la información vigente de precios y límites de Meta para tu cuenta y región.
La fórmula útil es costo total de la tarea = uso del modelo + herramientas o sandbox + tiempo del operador + costo de repetir ejecuciones. Max puede costar menos por tarea terminada si reduce reintentos o intervenciones lo suficiente para compensar la diferencia. También puede ocurrir lo contrario.
Separar las mejoras del modelo del soporte del sistema
Vuelvo siempre a este punto. Un agente Muse Spark 1.3 no es solo Muse Spark 1.3. El modelo razona y elige acciones; el sistema circundante decide qué contexto se conserva, qué herramientas existen, cómo funcionan los permisos, qué se reintenta y qué ocurre tras un fallo.
Meta dice que el modelo se entrenó para pedir ayuda al atascarse, conservar mejor instrucciones largas, resistir mejor inyecciones de prompts y confirmar antes de acciones importantes. Es útil, pero completar tareas todavía exige que el entorno mantenga el estado del repositorio, exponga fallos de pruebas, proteja credenciales, limite archivos y permita recuperarse sin perder el hilo.
Estado, permisos y recuperación
Registra si cada ejecución puede continuar tras un comando fallido, si conserva las salidas de herramientas, si distingue un tiempo de espera agotado de una prueba fallida y si vuelve al último estado seguro después de una mala edición.
La seguridad pertenece a la misma evaluación. Un modelo más potente puede mejorar el juicio, pero permisos deterministas, credenciales de alcance limitado, aprobaciones, controles de red y reversión siguen siendo responsabilidades del sistema. Al leer afirmaciones de seguridad del proveedor, recuerda que comportamiento del modelo y protecciones del entorno están relacionados, pero no son lo mismo.
Al mirar el lanzamiento así, cambió un poco mi perspectiva. “Razonamiento máximo” dejó de parecer un veredicto sobre el producto y pasó a ser una variable de un sistema controlado.
Límites y compromisos
Hay tres límites visibles. Las afirmaciones de eficiencia de 1.3 frente a 1.2 provienen de Meta y no resuelven la comparación entre razonamiento inferior y máximo. Los benchmarks públicos pueden aportar evidencia, pero cambian con entornos, herramientas, tareas y niveles de razonamiento; no convertiría una clasificación en un SLA de producción.
Tampoco pude confirmar en las páginas revisadas un ID inmutable de snapshot de Muse Spark 1.3, una retención concreta para cada nivel de Meta Model API ni un esquema completo de auditoría de razonamiento y herramientas. Son cuestiones de adquisición. Sin registrar la configuración exacta, un equipo no puede reproducir la comparación después.
Este artículo no implica que EvoX o EvoMap integren actualmente Muse Spark 1.3. El marco de evaluación se aplica a los sistemas de agentes de programación en general.
Preguntas frecuentes
¿Dónde está disponible actualmente Muse Spark 1.3 con razonamiento máximo?
El anuncio de Meta del 2 de septiembre de 2026 indica disponibilidad en Muse Code y Meta Model API. Aun así, verificaría cuenta y región inmediatamente antes de una prueba de producción.
¿Pueden los equipos fijar un snapshot del modelo?
No pude confirmar un compromiso público de fijación de snapshots inmutables en las páginas consultadas. No supongas que “Muse Spark 1.3” identifica una compilación fechada. Para reproducibilidad, registra el identificador exacto devuelto por la API y pregunta a Meta si tu cuenta permite fijar una versión o snapshot estable.
¿Qué controles de retención se aplican a solicitudes de Meta Model API?
Las páginas públicas de lanzamiento y modelo que pude verificar no indican una duración concreta. No la inventaría. Antes de enviar código propietario, confirma los términos actuales de uso y retención para tu nivel exacto de API en el portal de Meta, y distingue los términos de Muse Code de los de Model API directamente.
¿Qué registros identifican el razonamiento y las herramientas en cada ejecución?
Las páginas de Meta revisadas no ofrecen un esquema completo para esta comparación. Tu entorno debería registrar esfuerzo solicitado, identificador de modelo devuelto, ID de ejecución, tokens, nombre de herramienta, argumentos seguros o su hash, estado, duración, reintentos, aprobaciones y recuperación. La guía de observabilidad GenAI de OpenTelemetry muestra cómo representar de forma consistente llamadas al modelo, tokens y spans de herramientas; registrar contenido sensible de prompts y herramientas debe seguir siendo opcional y explícito.
¿Pueden los controles de Meta pausar una tarea larga de programación?
Meta afirma que Muse Spark 1.3 está mejor calibrado ante acciones irreversibles y puede solicitar ayuda o confirmación antes de pasos importantes. Eso favorece patrones de interrupción y aprobación, pero no lo trataría como garantía universal de pausa a nivel de API. Hay que verificar parada, aprobación, timeout y reanudación en Muse Code o en el entorno alrededor de Model API.
Para mí, la comparación del esfuerzo de razonamiento debe terminar con un registro que muestre si completó más trabajo, necesitó menos rescates y justificó latencia y costo, no con “max gana”. No estoy lista para cerrar el tema solo con afirmaciones del proveedor. Una tarea fija de repositorio dirá más.
Publicaciones anteriores:
- Confiabilidad del agente Claude Opus 4.7 examina otra cuestión de fiabilidad del modelo: por qué un razonamiento más fuerte sigue necesitando evidencia de finalización, recuperación y revisión humana.
- Ingeniería de entornos de agentes de IA explica cómo herramientas, estado, pruebas, memoria, orquestación y evaluación determinan el rendimiento real.
- Costo de despliegue de agentes de IA desglosa uso del modelo, herramientas, tiempo humano, repeticiones y costo por entregable aceptado para evaluar si max vale la pena.
- Flujo de trabajo de agentes de IA paso a paso ayuda a diseñar la tarea fija mediante planificación, ejecución, validación, revisión y seguimiento.